Du behöver en server-side cache, har läst två jämförelsesidor och båda säger att det beror på. Hjälpsamt. Så låt oss reda ut frågan om Redis kontra Memcached direkt: Memcached är det bättre valet när du vill ha en enkel, snabb cache och inget mer, medan Redis är det bättre valet när cachen behöver hantera strukturerad data, överleva en omstart eller avlasta din applikation.
Både Redis och Memcached är:
Det är där de flesta artiklar slutar. Den här fortsätter, eftersom de intressanta skillnaderna börjar efter den punkten.
Båda lagrar data i arbetsminnet för att göra applikationer snabbare, men de är inriktade på olika typer av problem.
Memcached är enkelt. Det erbjuder grundläggande nyckel-värde-lagring och är utmärkt för snabb cachning av data tack vare sin flertrådade prestanda.
Redis har stöd för mer komplexa datatyper och permanent datalagring, vilket gör det mångsidigt för ett bredare spektrum av uppgifter som meddelandehantering och sessionshantering. Det erbjuder även avancerade funktioner som datasharding, vilket innebär att en datamängd delas upp över flera servrar så att ingen enskild maskin behöver lagra allt, samt ett urval av strategier för borttagning av data.
Baserat på ett projekt vi utvecklade för en kund kommer jag att gå igenom hur de hanterar datalagring, skalbarhet och vilken av dem som presterar bäst i olika scenarier. Först, grunderna.
Redis, som står för Remote Dictionary Server, skapades 2009 av Salvatore Sanfilippo för att förbättra skalbarheten i den webblogganalysator som hans italienska startup höll på att bygga. Den första prototypen skrevs i Tcl och översattes senare till C. När Sanfilippo gjorde projektet till öppen källkod började det få genomslag. GitHub och Instagram var bland de första företagen som började använda det, och projektets egen dokumentation är än idag referensen för dess funktioner och begränsningar.
Memcached kom till lite tidigare, år 2003, och skapades av Brad Fitzpatrick för hans webbplats LiveJournal. Det utvecklades ursprungligen i Perl och översattes sedan till C. Några av världens största företag använder det, däribland Facebook, YouTube och Twitter, och dess funktionalitet finns dokumenterad i Memcached-wikin.
Redis är egentligen inte en nyckel-värde-lagring, utan en server för datastrukturer. De fem du kommer att använda mest är:
Utöver dessa finns även bitmappar, bitfält, HyperLogLogs (probabilistiska kardinalitetsräknare) och geospatiala index, samt strömmar för loggar som endast kan utökas. JSON, frågor, tidsserier och — från Redis 8 — vektoruppsättningar läggs till via moduler (dokumentation för Redis datatyper). Det är långt ifrån bara "nycklar och strängar", och den bredden är hela anledningen till att Redis är användbart i sammanhang där en enkel cache inte räcker till.
Redis har stöd för operationer på datatyper, vilket innebär att du kan läsa eller ändra en del av ett objekt utan att behöva läsa in hela objektet i din applikation, redigera det och spara tillbaka det.
För minneshantering används en inkapslad version av malloc/free, standardmekanismen i C för att begära och frigöra minne. Det är enklare än Memcacheds Slab-mekanism, som jag går in på nedan.
Nycklar kan vara upp till 512 MB, och detsamma gäller värden, vilket framgår av dess dokumentation för datatyperFör aggregerade datatyper som listor och mängder gäller den gränsen per element.
Memcached har inga datatyper. Det lagrar strängar indexerade med en strängnyckel, och det drar mindre minne än Redis för den fördelen.
Det begränsas också av minnet på maskinen där det körs. När det blir fullt börjar det rensa värden enligt principen "minst nyligen använd" (LRU). Dess allokeringsmekanism, Slab, delar upp minnet i block av olika storlekar och lagrar varje nyckel-värde-post i det block som passar. Det är detta som förhindrar att minnet fragmenteras i luckor som är för små för att återanvändas.
Nycklar har en maxgräns på 250 byte och värden på 1 MB. Det är dock standardvärden, och du kan höja den maximala slab-storleken vid uppstart (se Memcached-wikin).
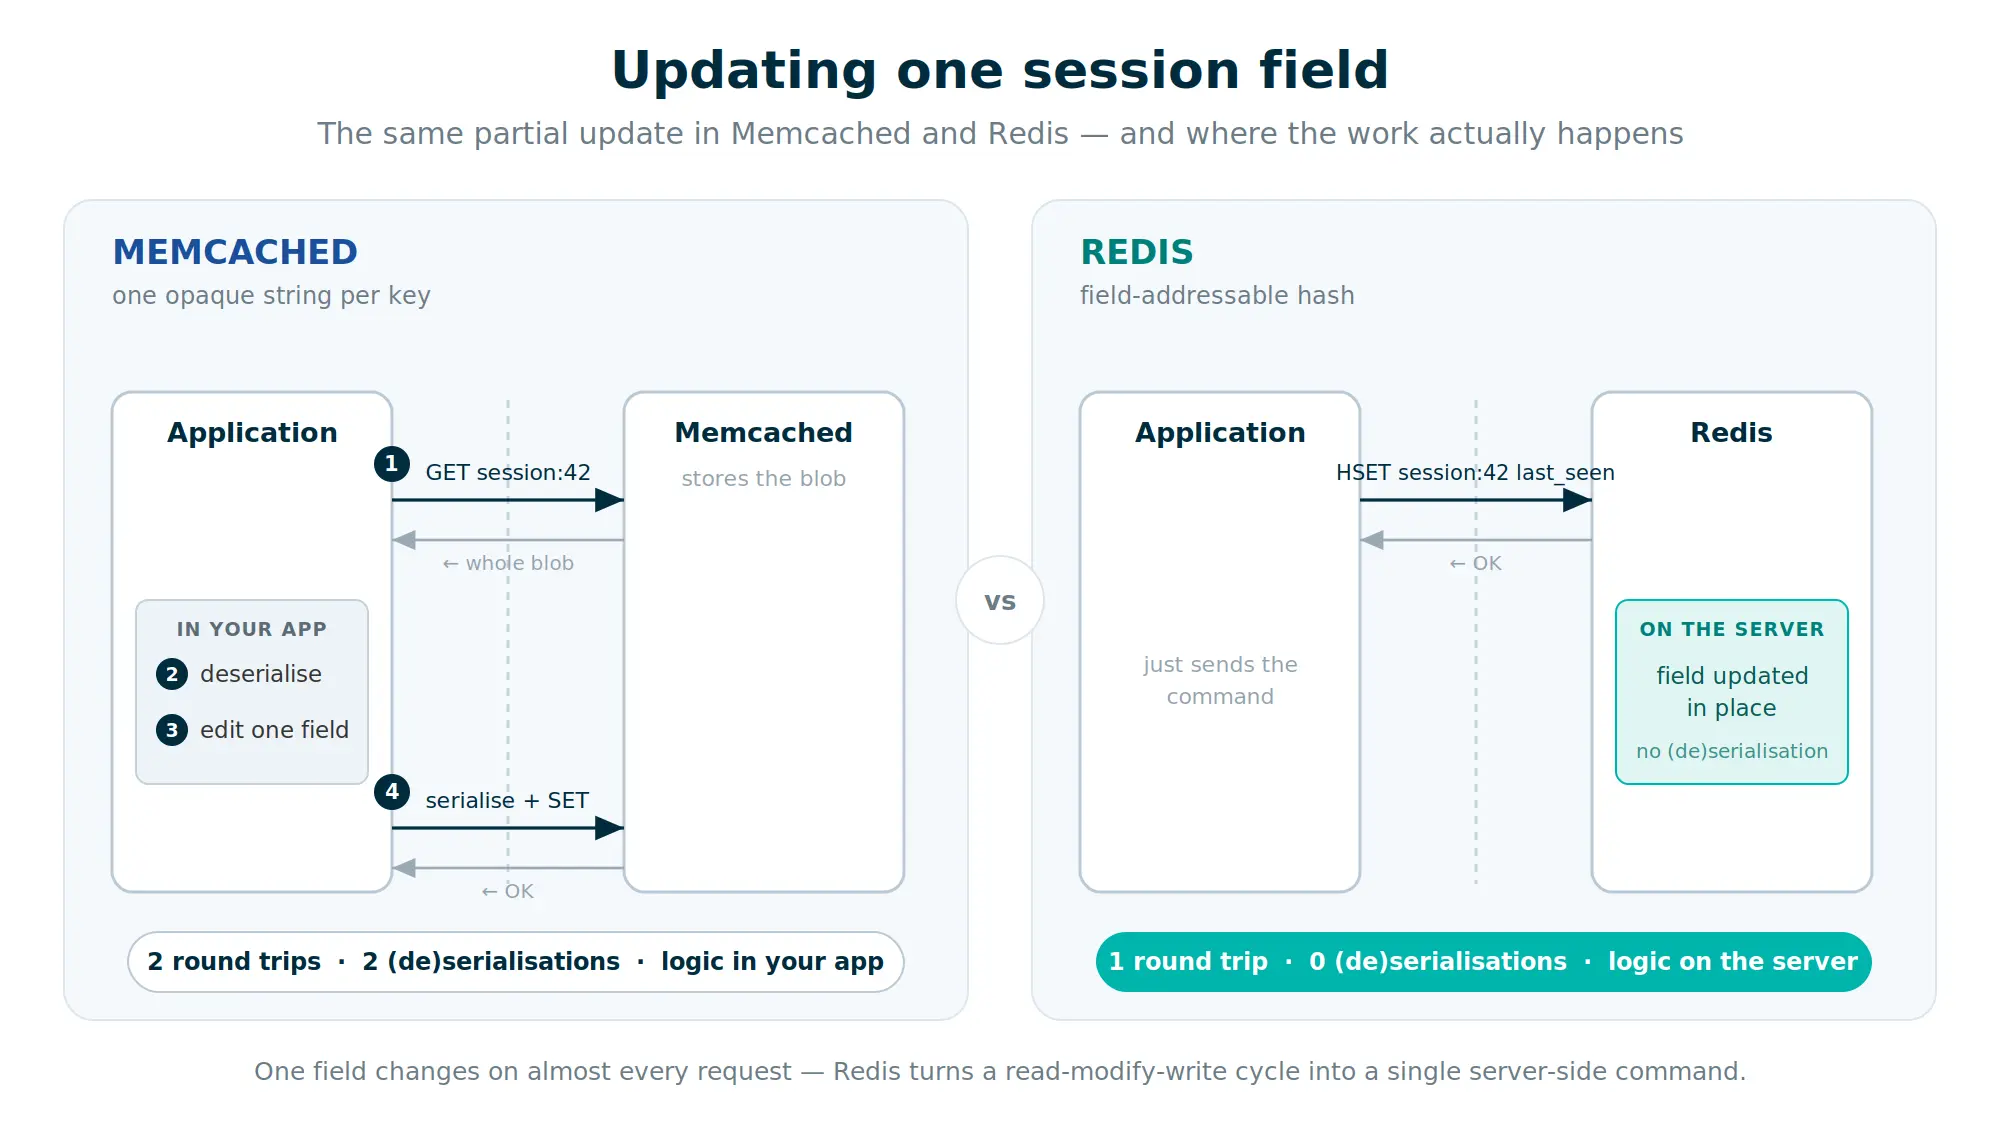
Se ett cachat objekt som en jacka som lämnas in i en garderob. Med Memcached kan du bara hämta ut hela jackan: för att ändra något i en ficka måste strängen laddas, deserialiseras, fältet redigeras, serialiseras och lagras igen.
Redis låter dig nå in i fickan. Datatypen hash ger dig åtkomst till varje fält individuellt, så att alla CRUD-operationer (skapa, läsa, uppdatera, ta bort) körs mot just det fältet. En nätverksförfrågan, ungefär till samma kostnad som en vanlig get eller set, ersätter fyra utbyten och två serialiseringssteg.
Här är samma sessionsuppdatering på båda sätten:
# Memcached — the whole session object is the unit of work
value   = mc.get("session:42")             # 1. fetch the whole blob
session = deserialise(value)               # 2. deserialise in app memory
session["last_seen"] = now()               # 3. edit one field
mc.set("session:42", serialise(session))   # 4. serialise + write it all back
# → 2 network round trips, 2 (de)serialisation steps, in your app code

# Redis — the field is the unit of work
HSET session:42 last_seen <now>            # one round trip, no (de)serialisation
# → the read-modify-write collapses into a single command on the server
Anledningen till att detta fungerar är inte specifik för vårt projekt. Redis egen dokumentation och oberoende prestandatester visar att det är att minska antalet nätverksförfrågningar, snarare än att snabba upp kommandon, som ökar genomströmningen – se prestandasektionen nedan för siffrorna.
Redis är i huvudsak enkeltrådat, vilket innebär att en kärna exekverar kommandona oavsett hur många kärnor maskinen har. (Trådad I/O introducerades i Redis 6, och Redis 8 samt Valkey-forken har utvecklat multitrådad I/O ytterligare – men själva kommandona körs fortfarande på en tråd; AWS noterar samma distinktion mellan enkeltrådad exekvering och multitrådad I/O i sin Jämförelse av ElastiCache-motorer.) Med inbyggt stöd för klustring skalar det istället väl horisontellt.
Klustring bygger på en master/slave-arkitektur, där en nod tar emot skrivningar och de andra lagrar kopior av datan. Varje master har två slavar för redundans, så om mastern går ner befordras en av dem automatiskt av systemet. Kostnaden ligger i underhållet: det är svårare att hålla flera synkroniserade noder i drift än en enskild nod.
Memcached skalar enkelt vertikalt eftersom det är multitrådat. Ge det fler kärnor och mer minne, så är saken klar.
Det skalar även horisontellt, på klientsidan, genom en distribuerad algoritm som du själv implementerar. Det kräver mer arbete än Redis, som har inbyggd klustring från start.
Den största skillnaden mellan dessa två är vad som överlever en omstart. Redis är (till största del) en datalagring i minnet och är inte flyktig. Memcached är en cache i minnet och är flyktig: starta om processen och innehållet är borta.
Redis har stöd för persistens, vilket är anledningen till att det kallas för en datalagring, på två sätt (Dokumentation om Redis-persistens):
En underprocess hanterar dessa filer, och den detaljen avgör vilken du bör välja.
Är en stor datamängd ett problem? För RDB, ja. Filen tar tid att skapa, vilket påverkar svarstiderna, även om den laddas snabbare vid uppstart än vad AOF-loggen gör.
Välj AOF när dataförlust inte är acceptabelt under några omständigheter. Den kan uppdateras vid varje kommando och eftersom den endast lägger till data uppstår inga korruptionsproblem. Den blir dock betydligt större än en RDB-ögonblicksbild.
Ingenting, enligt design. Ingen ögonblicksbild, ingen logg. En omstart, en krasch eller en failover innebär att cachen startar tom, och den första vågen av förfrågningar efteråt går rakt igenom till databasen.
Det fungerar bra när cachen innehåller härledd data som är billig att beräkna på nytt. Det blir ett problem för kapacitetsplaneringen när så inte är fallet.
Memcached är begränsat till evikteringspolicyn LRU (least recently used), medan Redis har stöd för åtta (Dokumentation om Redis-nyckeleviktering):
Vad du får ut av detta är kontroll. Med Memcached bestämmer LRU och du får leva med det. Med Redis kan du skydda de nycklar som inte får försvinna och låta allt annat vräkas runt dem.
Det är oftast här jämförelsesidor byter ut bevis mot påståenden. Låt oss använda siffror istället.
Redis publicerar sina egna genomströmningstal. Deras benchmark-dokumentation rapporterar att en enklare Linux-server som kör en enskild Redis-instans hanterar i storleksordningen 100 000 förfrågningar per sekund med små nyttolaster, med sub-millisekunders latens på ett lokalt nätverk. Det taket gäller för en kärna. Kommandoexekvering är enkeltrådad, så att lägga till kärnor på maskinen höjer inte detta. Redis 6 lade till trådad I/O, vilket parallelliserar socket-läsningar och -skrivningar, men själva kommandona körs fortfarande på en tråd.
Memcached är flertrådad från början till slut, så dess genomströmning ökar med antalet kärnor tills nätverksgränssnittet mättas. Det är hela dess prestandafördel, och den är genuin: på en maskin med många kärnor som serverar stora, enkla värden flyttar Memcached mer data per sekund än vad en enskild Redis-process kan. Det är därför AWS dokumenterar de två olika även inom samma hanterade tjänst – deras eget whitepaper noterar att Memcached "utnyttjar större [instans]storlekar med flera kärnor väl", medan Redis hanteras mer som en tillståndskänslig databas (Memcached vs. Redis: Prestanda i skala med Amazon ElastiCache).
Två förbehåll är viktigare än rubriksiffrorna. För det första är en Redis-distribution sällan en enskild process, och sharding över instanser vinner tillbaka flerkärnsfördelen till priset av klusterunderhåll. För det andra är operationer per sekund fel måttstock när ett Redis-kommando ersätter flera applikationsanrop. En uppdatering av ett hash-fält är ett nätverksutbyte där Memcached behöver en läsning, en deserialisering, en skrivning och en serialisering. Redis kan vara långsammare per operation och ändå komma i mål först.
Detta är inte bara vår egen erfarenhet; mekanismen är dokumenterad och mätbar. Eftersom varje kommando innebär ett nätverksanrop är det svarstiden – inte kommandoexekveringen – som vanligtvis begränsar genomströmningen. Redis egen guide för pipelining gör poängen tydlig: på en länk med 250 ms svarstid begränsas en server som klarar 100 000 förfrågningar per sekund till ungefär fyra per sekund tills du slutar betala för ett anrop per kommando. Oberoende benchmarking visar vinstens storlek: i ett flitigt citerat test kört på DigitalOceans infrastruktur, tog det att slå ihop anrop en standard redis-benchmark från cirka 97 000 GET/s till ungefär 1,35 miljoner GET/s – en vinst på ca 14 gånger som helt kom från att ta bort nätverksutbyten, inte från snabbare kommandon. Det är samma hävstång som vår ändring av sessionsobjekt använde, fast i en annan form: ett hash-kommando istället för en läsning, en deserialisering, en redigering, en serialisering och en skrivning. (Pipelining grupperar många kommandon; hash-typen slår ihop en läs-ändra-skriv-cykel – olika tekniker, identisk princip: färre resor över nätverket.)
Regeln är alltså: Memcached för en hög volym av oberoende läsningar av hela värden på en stor maskin. Redis där datans form gör att du kan utföra färre, smartare operationer.
Tre situationer rättfärdigar den operativa kostnaden, och de delar en gemensam nämnare: cachen gör något som dina applikationsservrar annars skulle behöva göra.
Memcached passar när cachen genuint är en cache: värden som skrivs i sin helhet, läses i sin helhet och som det är säkert att förlora.
Här är den del som sällan hamnar på en jämförelsesida. Vi kallar det för exit-kostnadstestet: innan du väljer en cache, fråga dig vad det skulle kosta att lämna den. De två svaren är inte symmetriska.
På Imaginary Cloud har vi använt båda i många olika kundprojekt. I ett av dem som jag var involverad i behövde vi välja mellan dem. Vi började med Memcached för dess enkelhet, användarvänlighet och smidiga installation, och eftersom vi bara behövde en cache var persistens inget krav. Efter en tids testande bytte vi till Redis för fördelarna med att ha datatyper.
Operationerna för datatyper passade den typ av data vi lagrade. Redis tillhandahåller även ett kommando för att söka efter nycklar som matchar ett mönster, tillsammans med många andra kommandon för att arbeta med nycklar, och det visade sig vara den funktion vi ständigt återkom till. Det blev den avgörande faktorn för migreringen.
Själva migreringen var okomplicerad eftersom Redis stöder de flesta kommandon som Memcached har. Peka om klienten, låt cachen fyllas på och fortsätt.
Att gå åt andra hållet är en helt annan historia. Memcached har inga datatyper, så varje kommando för Redis-datatyper måste översättas till flera Memcached-kommandon med databearbetning däremellan för att nå samma resultat. Den logiken hamnar tillbaka i applikationskoden som du precis hade flyttat ut den ifrån.
Den asymmetrin är testet. Börja med Memcached och du behåller en billig utväg till Redis. Börja med Redis, upptäck att du bara behövde en enkel cache, och du får skriva om applikationslogiken för att ta dig tillbaka. När kraven är genuint osäkra förtjänar exit-kostnaden mer vikt än något benchmark.
Redis är mer flexibelt och har fler funktioner. Memcached fyller fortfarande en viktig funktion och presterar i vissa fall bättre, eftersom flertrådshantering ger fördelar när du flyttar stora mängder enkel data.
Redis har stöd för dataoperationer tack vare sina datatyper, vilket minskar både antalet nätverksanrop och datamängden. En uppdatering av ett hash-fält kostar ungefär lika mycket som en vanlig get- eller set-operation, så arbetet utförs utan att belasta nätverket i onödan.
Så, finns det en vinnare? Nej, naturligtvis inte. Tillämpa prestandaregeln och gör sedan en analys av utgångskostnaderna. Välj Memcached för stora volymer av oberoende läsningar av hela värden på en kraftfull maskin. Välj Redis när datastrukturen tillåter färre och smartare operationer. När de två alternativen ligger nära varandra, välj det som är billigast att lämna. Vår erfarenhet är att man genom att väga för- och nackdelar mot varandra från början slipper en migrering mitt i projektet.
Om du godkänner arkitekturen snarare än skriver den, kokar den tekniska jämförelsen ner till tre kommersiella frågor. Vi använder dessa för varje infrastruktur- och stackval, inte bara cachelagring.
1. Vad kostar det att driva? Memcached har lägre minnesoverhead per objekt, vilket gör att samma arbetsmängd får plats i en mindre instans. Redis kostar mer per gigabyte cachelagrat när persistens och replikering är aktiverade, eftersom en RDB-snapshot kräver utrymme för den förgrenade barnprocessen och ett replikerat kluster multiplicerar antalet instanser. Liten skillnad vid några få gigabyte. Avsevärd vid några hundra.
2. Vem ansvarar för det på måndagsmorgonen? En enskild Memcached-instans kräver i princip noll underhåll. Ett Redis-kluster med master- och repliknoder, failover och optimering av persistens är ett system som någon måste ansvara för: övervaka det, testa failover och dimensionera snapshot-fönstret. Om den personen inte finns i ditt team är de ärliga alternativen en hanterad tjänst eller Memcached. ElastiCache eller MemoryDB flyttar arbetet till leverantören och lägger det på fakturan istället, vilket oftast är rätt avvägning för ett litet team.
3. Hur ser licensiering och kontinuitetsrisk ut? I mars 2024 gick Redis från BSD-licensen till en källkodstillgänglig dubbelmodell (RSALv2 och SSPLv1), vilket fick Linux Foundation att förgrena den sista BSD-utgåvan (7.2.4) som Valkey. I maj 2025 lade Redis 8 till AGPLv3 — en OSI-godkänd licens med öppen källkod — vid sidan av de källkodstillgängliga alternativen, så Redis levereras nu återigen under en trippel-licens, och Salvatore Sanfilippo hade återvänt till företaget året innan. Förgreningen bestod ändå: AWS själva påpekar att Redis 8.0 Community Edition är AGPLv3 (en copyleft-licens som många organisationer förbjuder) medan Memcached förblir BSD, och rekommenderar nu Valkey för nya ElastiCache-arbetsbelastningar (AWS: Jämför Redis och Memcached). Episoden är en påminnelse om att Redis är ett beroende med en kommersiell ägare och en licens som redan har ändrats under press. Memcached har varit BSD hela tiden utan en sådan historik. För de flesta team är detta inget hinder. För alla som bäddar in en cache i en produkt de distribuerar vidare — där AGPL-copyleft-klausulen kan ställa till det — är det en fråga att besvara innan koden skrivs, och Valkey är den tillåtande utväg som är värd att känna till.
Tid till värde gynnar oftast att börja enkelt. Memcached går snabbare att sätta upp, och som testet av utgångskostnader visar är det billigt att byta till Redis senare. Det omvända gäller inte.
Inte universellt. Vid små värden per operation ligger de nära varandra, och Redis levererar en genomströmning på cirka 100 000 förfrågningar per sekund för en enskild instans på enklare hårdvara. Memcached är flertrådat, så på en maskin med många kärnor som hanterar stora, enkla värden flyttar det mer data per sekund. Redis vinner där dess datatyper ersätter flera anrop mellan applikation och databas med ett enda kommando.
Ja, när kravet faktiskt är en cache. För transient data, enkla värden, inget behov av persistens och när det finns gott om kärnor: Memcached är enklare att köra, har lägre minnesoverhead och nästan ingen operativ komplexitet.
Ja, och det är den enklare riktningen, vilket är hela poängen med testet för utgångskostnader. Redis stöder de flesta kommandon som Memcached har, så i praktiken pekar du om klienten och låter cachen fyllas på nytt. Att gå åt andra hållet innebär att skriva om datatypsoperationer till flera Memcached-kommandon plus bearbetning på applikationssidan.
Nej. Memcached är en volatil cache i minnet: starta om den och innehållet är borta. Redis har persistens genom RDB-snapshots, punkt-i-tiden-dumpar till disk, eller en AOF-logg som spelar upp varje skrivkommando vid start.
Memcached, sett till infrastrukturkostnader, tack vare lägre minnesoverhead per objekt och enkelheten med enskilda instanser. Redis kostar oftast mer när replikering och persistens aktiveras. Kalkylen ändras om Redis avlastar dina applikationsservrar eller din databas, eftersom den besparingen kan överväga skillnaden i cachekostnad.
Redis klustrar inbyggt, med master- och repliknoder samt automatisk failover. Memcached distribuerar på klientsidan med hjälp av en sharding-algoritm som du implementerar själv. Hanterade tjänster erbjuder båda – och för nya driftsättningar använder ElastiCache och Memorystore numera som standard Valkey-forken med BSD-licens, vilket generellt är den förnuftiga vägen för team utan en dedikerad plattformsingenjör.
I allt högre grad, ja – det är anledningen till att den här jämförelsen har ett tredje namn sedan 2024. Valkey är Linux Foundations BSD-licensierade fork av Redis 7.2.4, API-kompatibel och numera standard hos de stora hanterade tjänsterna. Om din enda tvekan kring Redis är licensen, tar Valkey bort den utan att ändra hur du skriver mot cachen.
Försöker du bestämma vilken cache din arkitektur ska byggas på? Vi hjälper ingenjörsteam att välja infrastruktur som de har råd att köra och, lika viktigt, har råd att byta ut senare. Prata med vårt team om vart ditt system är på väg.
Webbutvecklare på Imaginärt moln, som är entusiastisk över Node.js och allt relaterat till back-end-utveckling.

VD på Imaginary Cloud och medförfattare till boken Product Design Process. Jag gillar mat, vin och Krav Maga (inte nödvändigtvis i den ordningen).
LinkedIn
People who read this post, also found these interesting: