Written by:

Last Published:
3 novembre 2026
•

Tout le monde veut un agent IA. Très peu de gens savent quel problème il est censé résoudre. La réponse courte : ne créez un agent que lorsque le travail est complexe, variable et nécessite du discernement. Sinon, l'automatisation traditionnelle est moins chère, plus rapide et plus facile à auditer.
Cet écart coûte cher. Une grande partie des projets d'IA agentique devrait être annulée avant même de générer de la valeur, en raison de l'escalade des coûts, d'une valeur commerciale floue ou de contrôles des risques inadéquats. De nombreux cas d'usage vendus comme « agentiques » ne nécessitent même pas une telle implémentation. En d'autres termes, une grande partie des problèmes commence par un mauvais choix de mission.
Posez-vous donc une question avant de construire quoi que ce soit : ce flux de travail nécessite-t-il vraiment un agent ? Souvent, la réponse est non. Une automatisation bien conçue peut accomplir la tâche plus rapidement, à moindre coût et avec moins d'imprévus.
C'est pourquoi ce guide sur la création d'un agent IA pour votre entreprise commence par une décision, et non par un tutoriel. Il vous propose un test en cinq questions, un exemple concret chez Imaginary Cloud où l'automatisation traditionnelle a gagné, et six étapes pour créer un agent lorsque la réponse est oui.
Un agent IA est un système dans lequel un modèle de langage décide, étape par étape, des actions à entreprendre et des outils à utiliser pour atteindre un objectif. L'automatisation traditionnelle suit un chemin que vous avez défini à l'avance. La différence réside dans celui qui choisit l'itinéraire : vous ou le modèle.
| Automatisation traditionnelle | Agent IA | |
|---|---|---|
| Qui choisit l'itinéraire | Vous, à l'avance | Le modèle, étape par étape |
| Idéal pour | Règles connues et données structurées | Entrées désordonnées et décisions de jugement |
| Coût par exécution | Faible et prévisible | Plus élevé et variable (appels au modèle) |
| Risque principal | Se casse quand le processus change | Actions erronées ou dangereuses sans garde-fous |
| Auditabilité | Simple | Exige une journalisation et une supervision délibérées |
Anthropic trace la même limite : les workflows orchestrent les modèles et les outils via des chemins de code prédéfinis, tandis que les agents permettent au modèle de diriger son propre processus et l'utilisation de ses outils.
Imaginez un train et un taxi. Un train suit un itinéraire fixe, coûte peu par passager et ne vous réserve presque jamais de surprises. Un taxi va partout, s'adapte à une route barrée et coûte plus cher par trajet. Personne ne prend un taxi pour effectuer un trajet déjà desservi par le train.
De plus, la plupart des systèmes réels se situent entre les deux. Un workflow comportant une ou deux étapes agentiques, là où le jugement est réellement nécessaire, constitue souvent le compromis idéal. Nous y reviendrons lors des étapes de construction.
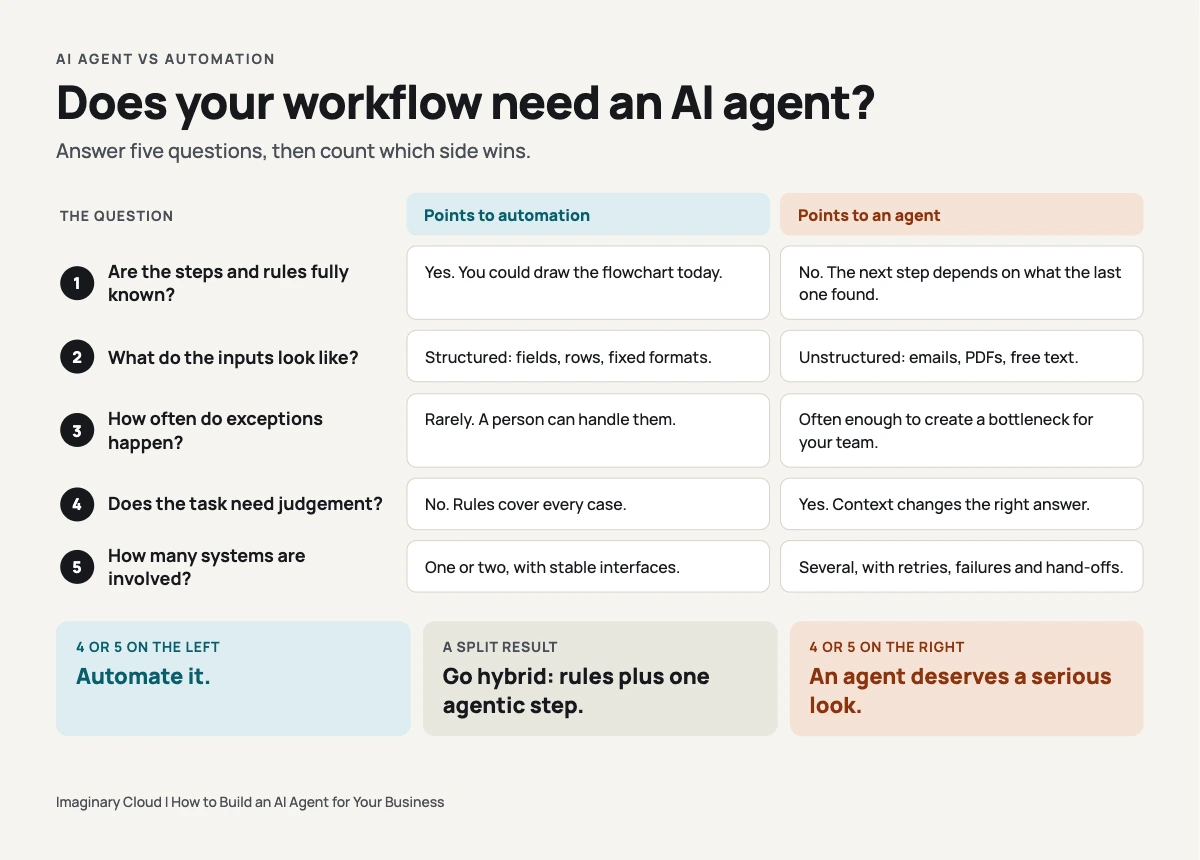
Le test en cinq questions examine les étapes, les entrées, les exceptions, le jugement et les systèmes. Si la plupart des réponses pointent vers un travail complexe et variable, un agent IA mérite une attention particulière. Si elles pointent vers des règles connues, l'automatisation traditionnelle sera moins coûteuse, plus rapide et plus facile à auditer.
| Question | Penche pour l'automatisation | Penche pour un agent |
|---|---|---|
| 1. Les étapes et les règles sont-elles entièrement connues ? | Oui. Vous pourriez dessiner l'organigramme dès aujourd'hui. | Non. L'étape suivante dépend de ce que la précédente a révélé. |
| 2. À quoi ressemblent les entrées ? | Structurées : champs de formulaire, lignes de base de données, formats fixes. | Non structurées : e-mails, PDF, texte libre dans de nombreux formats. |
| 3. À quelle fréquence les exceptions surviennent-elles ? | Rarement. Une personne peut les gérer. | Assez souvent pour que tout envoyer à une personne crée un goulot d'étranglement. |
| 4. La tâche exige-t-elle du jugement ? | Non. Les règles couvrent tous les cas. | Oui. Le contexte change la bonne réponse. |
| 5. Combien de systèmes sont concernés ? | Un ou deux, avec des interfaces stables. | Plusieurs, avec des nouvelles tentatives, des pannes et des transferts. |
Évaluez simplement. Quatre ou cinq réponses à gauche : automatisez. Quatre ou cinq à droite : un agent mérite une attention particulière. Un résultat mitigé indique généralement une approche hybride, avec des règles pour les parties prévisibles et un agent pour les parties complexes.
Gardez une règle supplémentaire sur un post-it. AWS conseille de choisir la solution la plus simple qui fonctionne, et vous demande de mettre en balance la latence ainsi que le coût total de l'inférence, de l'infrastructure et de la supervision humaine par rapport aux bénéfices. Les agents sont rentables lorsque la flexibilité supplémentaire justifie cet investissement.
Utilisez un agent IA lorsque le travail est complexe et nécessite du jugement. Évitez-le lorsque les règles sont connues et les données structurées, lorsque les réponses doivent être garanties sans examen humain, lorsque la rapidité est critique ou lorsque le processus n'est pas documenté. Dans ces cas, un agent ajoute des coûts et des risques sans apporter de valeur ajoutée.
Les enjeux sont réels : Gartner prévoit que plus de 40 % des projets d'IA agentique seront annulés d'ici fin 2027, citant l'escalade des coûts, une valeur commerciale floue ou des contrôles des risques inadéquats. Il note également que de nombreux cas d'usage vendus comme agentiques ne nécessitent pas d'implémentation agentique.
Voici les quatre cas où l'automatisation simple l'emporte :
Sedna, une entreprise de communications maritimes, souhaitait réduire le coût des flux de travail Tray.io derrière ses intégrations. Imaginary Cloud a optimisé les flux de travail existants, puis les a migrés vers des fonctions AWS Lambda personnalisées. Résultat publié : une réduction de 80 % des coûts Tray.io. Aucun agent requis.
Sedna exploite deux plateformes basées sur les données, Stream et Pulse, pour la communication dans le secteur du transport maritime et de la chaîne d'approvisionnement. Toutes deux dépendent d'intégrations qui déplacent et traitent les données entre des systèmes externes. Ces intégrations étaient construites dans Tray.io, et le coût de leur exécution était la cible.
Le travail s'est déroulé en deux phases. D'abord l'optimisation : améliorer les flux de travail Tray existants et en créer de nouveaux si nécessaire. Ensuite, la migration vers une solution personnalisée hébergée sur AWS, avec les intégrations Tray converties en fonctions AWS Lambda (de petits morceaux de code qui s'exécutent à la demande dans le cloud).
En cours de route, l'équipe a mis en place un processus CI/CD (pipelines automatisés qui testent et déploient le code) pour les plugins de synchronisation de données. Ils ont également construit des « auto-taggers », une logique personnalisée qui étiquette les e-mails pour les clients de Sedna. Un développeur backend et un développeur full-stack ont travaillé au sein de l'équipe de Sedna selon un modèle d'équipes gérées. Vous pouvez lire l'étude de cas complète sur Sedna ici.
Soumettez maintenant ce travail au test des cinq questions. Les intégrations suivent des chemins définis entre les systèmes, et même l'étiquetage des e-mails reposait sur une logique personnalisée plutôt que sur un jugement ouvert. Selon notre lecture, presque chaque réponse se situe dans la colonne de gauche. (Ceci est notre analyse du cas, pas une déclaration de Sedna.)
C'est là que réside la leçon. Lorsque l'itinéraire est connu, le véhicule le moins cher est le train. Ajouter un modèle pour décider de choses que le code connaît déjà aurait ajouté un coût d'inférence par exécution, de la latence et un élément supplémentaire à auditer.
Une réduction de 80 % est un pourcentage, pas une période de récupération, cependant. Ce qui nous amène à mesurer le rendement.
Mesurez le ROI d'un agent en comparant la valeur mensuelle qu'il crée par rapport à son coût mensuel total, incluant l'inférence, les intégrations, la supervision et la maintenance. Établissez la base de référence avant le lancement. Suivez ensuite le délai de rentabilisation : la rapidité avec laquelle un projet pilote restreint montre un résultat mesurable, avant de financer un déploiement plus large.
Une version simple ressemble à ceci :
La base de référence est ce qui rend l'exemple de Sedna utile. Une seule ligne de coût, mesurée avant et après, vous donne un chiffre incontestable. Les agents nécessitent la même discipline, en plus des lignes de coûts supplémentaires que l'automatisation ne comporte pas.
Le délai de rentabilisation est tout aussi important que le retour sur investissement. Un projet pilote ciblé qui apporte des résultats rapides vous fournit les preuves nécessaires pour financer un déploiement à plus grande échelle. Un programme vaste qui ne montre aucun résultat au bout d'un an produit l'effet inverse.
L'ambition n'est pas le problème. L'enquête State of AI de McKinsey, publiée en août 2026, a révélé que 40 % des grandes entreprises, celles réalisant plus d'un milliard de dollars de chiffre d'affaires, déploient des agents dans au moins une fonction, contre 27 % l'année précédente. Les organisations qui les rejoindront avec une base de référence claire seront celles qui financeront encore le projet en 2027.
Achetez une solution sur étagère lorsqu'un outil existant couvre déjà votre cas d'usage. Développez en interne si vous disposez d'ingénieurs capables de gérer un agent en production. Faites appel à une équipe externe lorsque le flux de travail est spécifique à votre entreprise, implique plusieurs systèmes ou nécessite des garde-fous et des pistes d'audit que votre équipe n'a jamais mis en place auparavant.
Voici comment comparer ces trois approches :
Quelle que soit l'approche choisie, déterminez qui sera responsable de l'agent une fois qu'il sera en service. Quelqu'un doit surveiller les journaux, gérer les exceptions et effectuer les mises à jour lorsque votre processus évolue. Sans responsable, même un agent performant finit par devenir obsolète.
La création d'un agent repose sur six étapes : choisir un cas d'usage précis, cartographier le processus en détail, définir une architecture, sélectionner votre pile technologique, construire les outils et les couches de raisonnement, puis lancer par phases et surveiller. Commencez petit. La plupart des échecs sont dus à une portée trop large, pas au code.
Chaque étape se termine par un point de contrôle : une validation à obtenir avant de passer à la suite.
Choisissez un flux de travail avec un déclencheur clair, un responsable identifié et un résultat mesurable. « Trier les factures fournisseurs entrantes » est un cas d'usage. « Améliorer les opérations grâce à l'IA » est un vœu pieux.
Définissez par écrit ce qu'est un succès en chiffres avant toute construction : heures économisées, taux d'erreur, temps de résolution. C'est votre base de référence.
Point de contrôle : Vous pouvez définir le cas d'usage, le responsable et l'indicateur de succès en deux phrases.
Parcourez le processus de bout en bout avec les personnes qui le réalisent. Listez les outils qu'elles utilisent, les décisions qu'elles prennent et, surtout, les cas qui posent problème.
Les cinq principales exceptions sont plus importantes que le scénario idéal. Elles vous indiquent où l'agent doit faire preuve de discernement, où il doit s'arrêter et quand il doit passer le relais à un humain.
Point de contrôle : les principales exceptions et les règles de transfert sont consignées par écrit.
Vous disposez de trois grandes options. Un agent orchestré par un grand modèle de langage (LLM) laisse le modèle décider de la séquence des étapes. Un agent de flux de travail suit une séquence fixe avec des appels au modèle intégrés. Une approche hybride combine les deux.
Commencez par un flux de travail et n'ajoutez des étapes agentiques que là où le jugement est nécessaire. Les conseils d'Anthropic sont de trouver la solution la plus simple possible et de n'augmenter la complexité que lorsqu'elle améliore manifestement les résultats, car les systèmes agentiques sacrifient souvent la latence et le coût au profit d'une meilleure performance des tâches.
Méfiez-vous des conceptions multi-agents, où plusieurs agents se transmettent le travail, tant qu'un seul agent n'a pas fait ses preuves. Ils ajoutent de la coordination, des coûts et de nouvelles sources d'échec. Commencez par un seul agent et une seule tâche.
Étape de validation : vous pouvez expliquer pourquoi l'architecture choisie est la plus simple qui fonctionne.
Pensez en termes de couches plutôt que de marques. Vous avez besoin d'une couche modèle, d'une couche d'orchestration pour gérer les étapes et les appels d'outils, d'une couche d'intégration pour connecter vos systèmes, et d'une couche d'évaluation et de surveillance pour savoir si tout fonctionne.
Le choix du modèle est une décision aussi bien commerciale que technique. Les modèles propriétaires permettent généralement de démarrer plus rapidement et sont souvent plus performants dès le départ. Les modèles open source vous offrent un meilleur contrôle sur l'hébergement, les coûts et les données, mais impliquent une charge d'ingénierie plus importante. Quel que soit votre choix, assurez-vous que le modèle reste interchangeable.
La confidentialité entre également en ligne de compte ici. Si l'agent doit accéder à des données personnelles, le RGPD s'applique. Déterminez quelles données le modèle peut voir, où elles sont traitées et qui peut lire les journaux, et impliquez vos équipes de sécurité et juridiques avant la construction, et non après.
Étape de validation : l'accès aux données, le lieu d'hébergement et la journalisation sont validés par la sécurité.
Commencez par la couche outils : les intégrations que l'agent appellera pour lire ou écrire des données. Construisez ensuite la couche de raisonnement qui décide quand les utiliser. Consacrez ensuite du temps réel aux cas limites, car c'est là que les agents se distinguent des simples démonstrations.
Limitez les autorisations dès le premier jour. Le Top 10 de l'OWASP 2025 pour les applications LLM répertorie à la fois l'injection de prompt et l'agence excessive comme des risques majeurs. Donnez à l'agent le niveau d'accès minimal requis et exigez une approbation humaine pour toute action irréversible, telle que les paiements, les suppressions ou les messages destinés aux clients.
Étape de validation : l'agent réussit une série de tests basés sur des cas réels, y compris les plus complexes.
Commencez par un essai aux côtés de vos équipes, souvent appelé mode fantôme : l'agent génère des réponses, mais personne ne les applique. Ensuite, dirigez une petite partie des cas réels vers lui, avec une vérification humaine. N'élargissez le périmètre que lorsque les résultats sont probants.
Enregistrez chaque action et chaque décision. Le cadre volontaire NIST AI Risk Management Framework constitue une base utile à cet effet, articulée autour de la gouvernance, de la cartographie, de la mesure et de la gestion des risques.
Étape de validation : les chiffres du projet pilote surpassent votre référence avant d'élargir l'accès.
Les erreurs les plus fréquentes consistent à commencer par l'outil plutôt que par le problème, à faire l'impasse sur la situation de référence, à accorder trop d'accès à l'agent et à lancer le projet sans évaluation ni suivi. Ces quatre erreurs sont évitables et il est toujours moins coûteux de les corriger avant le lancement qu'après.
Un agent IA est un logiciel qui utilise un modèle de langage pour atteindre un objectif en choisissant lui-même ses actions et ses outils, comme lire un document, interroger un système ou mettre à jour un enregistrement. Un chatbot se contente de répondre à des questions. Un agent peut agir sur vos systèmes, c'est pourquoi il nécessite des garde-fous.
Achetez si un outil prêt à l'emploi couvre déjà votre cas d'usage. Développez si vous disposez d'ingénieurs capables de gérer un agent en production. Faites appel à un partenaire si le flux de travail est spécifique à votre entreprise, s'il touche plusieurs systèmes ou s'il nécessite des pistes d'audit. De nombreuses entreprises commencent avec un partenaire pour leur premier agent.
Cela dépend du nombre de systèmes auxquels l'agent se connecte, de la qualité de vos données, de sa capacité à lire ou à écrire, et du volume de requêtes traitées. N'oubliez pas les coûts d'exploitation : l'inférence, la supervision et la maintenance se poursuivent après le lancement. Une estimation ciblée est plus utile qu'une fourchette de prix générique.
Un prototype ciblé peut être testé en quelques semaines. Un système de production avec des garde-fous, une évaluation et un suivi prend plus de temps, et le périmètre est le facteur déterminant. Lancer d'abord un cas d'usage précis permet d'obtenir un résultat mesurable plus rapidement et plus sûrement que de construire un assistant généraliste.
Pour un cas d'usage limité, oui. Les plateformes no-code et un partenaire peuvent lancer un projet pilote sans data scientists. La production est différente : les intégrations, les autorisations, les tests et le suivi nécessitent des compétences en ingénierie, en interne ou en externe. Considérez le no-code comme un moyen d'apprendre, pas comme un moyen de contourner les mesures de sécurité.
Les agents gèrent mieux les entrées désordonnées, comme les e-mails et les PDF, que les outils basés sur des règles. Ils ont tout de même besoin de données accessibles et autorisées, ainsi que d'un ensemble d'exemples réels avec des réponses correctes connues, afin que vous puissiez tester la fiabilité de l'agent avant qu'il n'intervienne sur des opérations réelles.
La RPA répète des étapes scriptées entre différents systèmes et échoue dès que l'écran ou le processus change. Un agent IA poursuit un objectif en choisissant ses actions et ses outils, ce qui lui permet de gérer les variations. Si les étapes ne changent jamais, la RPA ou une automatisation classique suffit généralement.
Il n'existe pas de meilleur constructeur unique. Évaluez les options en fonction de leur capacité à se connecter à vos systèmes, de la gestion des autorisations et de la journalisation, de la possibilité de changer de modèle, de la propriété de vos données et de la facilité de sortie. Testez-en deux ou trois sur un cas d'usage réel avant de vous engager.
Deux points à retenir. Décidez avant de construire : passez votre flux de travail au crible des cinq questions et soyez prêt à accepter que l'automatisation traditionnelle soit la réponse. Ensuite, mesurez dès le premier jour, avec une base de référence, afin que le chiffre que vous communiquez soit défendable.
Un agent est un moyen, pas une fin. Les 80 % de Sedna proviennent du choix du bon outil pour un parcours connu. Quoi que vous construisiez, la meilleure façon de créer un agent IA pour votre entreprise est d'abord de vous assurer que vous en avez réellement besoin.
Si vous souhaitez un second avis sur votre cas d'usage, c'est là que nos services de développement d'agents IA entrent en jeu. Nous concevons et développons des agents IA et des outils d'automatisation basés sur l'IA. Vous voulez voir comment nous travaillons sur des projets réels ? Parcourez nos études de cas, ou réservez un appel pour soumettre votre flux de travail au test des cinq questions.
Alexandra Mendes est Senior Growth Specialist chez Imaginary Cloud et possède plus de 3 ans d'expérience dans la rédaction sur le développement logiciel, l'IA et la transformation numérique. Après avoir suivi une formation en développement frontend, Alexandra a acquis des compétences pratiques en programmation et travaille désormais en étroite collaboration avec les équipes techniques. Passionnée par la manière dont les nouvelles technologies façonnent les entreprises et la société, Alexandra aime transformer des sujets complexes en contenus clairs et utiles pour les décideurs.
People who read this post, also found these interesting: