Written by:

Last Published:
17 novembre 2026
•
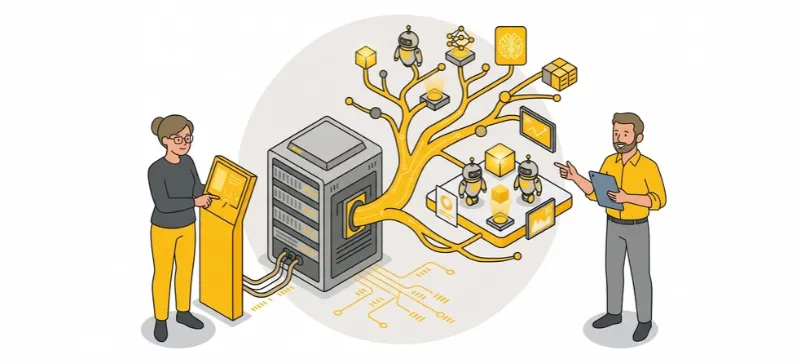
Une usine à IA est un système reproductible permettant de transformer des données en une IA opérationnelle en production. Le terme revêt deux significations : un centre de données conçu spécifiquement pour produire des résultats d'IA à grande échelle, et un modèle opérationnel qui permet de faire passer l'IA du stade de projet pilote à celui de production de manière systématique.
La première définition concerne les infrastructures : racks de processeurs graphiques (GPU), refroidissement liquide et jetons produits par seconde. (Un jeton est une petite unité de texte lue ou écrite par un modèle.) La seconde concerne les méthodes : une manière reproductible de faire passer une IA d'un projet pilote prometteur à une solution sur laquelle les clients peuvent compter.
Imaginez la première comme une centrale électrique et la seconde comme la cuisine qui utilise cette énergie pour préparer les plats. Dans les deux cas, vous avez besoin d'électricité. Mais l'électricité ne définit pas le menu.
Alors, une usine à IA n'est-elle qu'un centre de données avec un meilleur marketing ? En partie, selon l'interlocuteur. Ce guide distingue les deux définitions et se concentre principalement sur celle qui détermine si votre investissement dans l'IA sera rentable : la couche logicielle et de livraison.
Une « usine à IA » est un processus permanent permettant de transformer des données en une IA opérationnelle et fiable en production. Ce terme revêt deux significations. En matière d'infrastructure, il désigne un centre de données spécifiquement conçu pour produire de l'IA à grande échelle. En matière de logiciel, il s'agit d'un modèle opérationnel : les données, l'évaluation, le déploiement et la gouvernance sont intégrés dans un pipeline unique, permettant ainsi d'accélérer la mise en œuvre de chaque nouveau cas d'usage.
Voici comment ces deux visions se comparent.
| Vue infrastructure | Vue logicielle et livraison | |
|---|---|---|
| Qui utilise le terme | NVIDIA, HPE, Cisco, Dell | Écoles de commerce, équipes produit et ingénierie |
| Ce que c'est | Calcul spécialisé : GPU, réseau, stockage, refroidissement | Un pipeline : données, évaluation, agents, gouvernance, mise en production |
| Ce qu'elle produit | De l'intelligence, mesurée en tokens | Des fonctionnalités d'IA opérationnelles, livrées de façon répétée |
| Indicateur clé | Débit de tokens et efficacité énergétique | Délai entre pilote et production, coût par cas d'usage |
| Acheteur type | Équipes infrastructure, fournisseurs de cloud et souverains | CTO, responsables produit et métier |
La définition logicielle est la plus ancienne. Dans leur ouvrage paru en 2020, *Competing in the Age of AI*, les professeurs de la Harvard Business School, Marco Iansiti et Karim Lakhani, décrivent l'usine à IA comme le moteur interne des entreprises pilotées par l'IA, et HBS Online continue de l'enseigner comme un système transformant les données en connaissances grâce à des processus reproductibles.
La définition liée à l'infrastructure est apparue plus tard, lorsque NVIDIA a commencé à en faire la promotion en 2024. Les piliers de la HBS sont un pipeline de données, le développement d'algorithmes, une infrastructure logicielle et une plateforme d'expérimentation. Aucun d'entre eux n'est un GPU.
Une usine à IA NVIDIA est une infrastructure informatique spécialisée qui gère l'intégralité du cycle de vie de l'IA, de l'ingestion des données à l'entraînement, en passant par le réglage fin et l'inférence à haut volume (l'étape où un modèle entraîné répond à des requêtes réelles). Sa production est de l'intelligence, mesurée en jetons. En résumé, il s'agit d'un centre de données conçu pour fabriquer de l'intelligence artificielle, et non pour héberger des sites web.
Le propre glossaire de NVIDIA décrit une usine à IA comme un empilement de pipelines de données, d'infrastructures d'inférence, de jumeaux numériques (répliques virtuelles utilisées pour concevoir et tester un site avant sa construction) et de matériel complet, des GPU aux systèmes de refroidissement. Il précise que le produit principal est « l'intelligence, mesurée par le débit de jetons ». Le terme a gagné en popularité en 2024, lorsque le PDG de NVIDIA a annoncé que plusieurs entreprises construiraient des usines à IA en utilisant sa technologie.
HPE et Cisco utilisent le même cadre avec une nuance.
HPE décrit une usine à IA comme une combinaison d'infrastructure, de pipelines de données, de modèles, de gestion du cycle de vie et de gouvernance au sein d'un système unique. Cisco la définit comme un environnement conçu pour industrialiser la manière dont les modèles sont produits, entraînés et déployés.
Les partenaires commercialisent la version NVIDIA sous forme de produits, tels que la Dell AI Factory with NVIDIA et la Cisco Secure AI Factory with NVIDIA.
Notez que même les fournisseurs de matériel incluent la gouvernance et la gestion du cycle de vie. Leur réponse est une architecture de référence que vous achetez. La question sous-jacente, à savoir comment gérer tout cela au quotidien, incombe à votre organisation.
Non : un centre de données est un bâtiment qui héberge des ressources informatiques. Une usine à IA, au sens infrastructurel, est un centre de données conçu autour des charges de travail liées à l'IA, avec un accent mis sur la vitesse d'inférence et l'efficacité énergétique. Au sens logiciel, ce n'est pas un bâtiment, mais le processus qui détermine ce qui s'exécute à l'intérieur de celui-ci ou sur une capacité cloud louée.
C'est là le cœur du débat entre usine à IA et centre de données. Le tableau ci-dessous présente les trois concepts côte à côte.
| Centre de données traditionnel | Usine à IA (infrastructure) | Usine à IA (logiciel) | |
|---|---|---|---|
| Objectif | Calcul généraliste | Entraînement et inférence d'IA à grande échelle | Mettre l'IA en production de façon répétée |
| Optimisé pour | Stockage, récupération, services web | Tokens par seconde, énergie par token | Réutilisation, qualité, rapidité de mise en production |
| Production | Services et données | Tokens | Fonctionnalités d'IA livrées et surveillées |
| Responsable | DSI ou fournisseur de cloud | Équipes infrastructure ou plateforme | Produit et ingénierie, avec un responsable métier |
| Faut-il vos propres GPU ? | Pas nécessairement | Oui, ou loués | Non, la capacité peut être louée |
NVIDIA affirme que les centres de données classiques gèrent l'informatique à usage général, tandis qu'une « usine d'IA » est conçue pour les charges de travail liées à l'IA. Cisco résume la situation plus simplement : les centres de données traditionnels stockent et récupèrent des informations, alors que les usines d'IA génèrent de l'intelligence. Ces deux définitions se concentrent sur le matériel. Aucune ne vous dit si votre chatbot, votre pipeline documentaire ou votre modèle de prévision survivra à une confrontation avec de vrais utilisateurs.
Ce point de vue est le nôtre, et non une définition fournie par un vendeur. Dans le débat entre usine d'IA et centre de données, la question pour un dirigeant n'est pas de savoir quoi acheter, mais quel problème résoudre.
En termes logiciels, une usine d'IA est le pipeline qui permet de faire passer l'IA du stade de projet pilote à celui de production, de manière systématique. Elle connecte les données prêtes à l'emploi, l'évaluation, les agents ou modèles, l'ingénierie de mise en production et la gouvernance, avec un responsable à chaque étape. L'objectif n'est pas de créer un modèle ingénieux, mais de déployer le dixième cas d'usage beaucoup plus rapidement que le premier.
Pourquoi s'en préoccuper ? Parce que le taux d'échec est élevé et que les causes sont banales. Gartner prévoit que plus de 40 % des projets d'IA agentique (projets basés sur des agents d'IA capables d'agir) seront annulés d'ici fin 2027, citant l'escalade des coûts, une valeur métier floue et des contrôles des risques inadéquats. Il prédit également que, d'ici 2026, les organisations abandonneront 60 % des projets d'IA non soutenus par des données prêtes pour l'IA.
Coût, valeur, risque, données. Une usine d'IA logicielle existe pour apporter une réponse à chacun de ces points.
Elle comporte cinq couches.
Commencez par les données dont votre cas d'usage a réellement besoin, identifiez qui en est responsable et vérifiez leur qualité. Établissez une base de référence avant de construire quoi que ce soit, par exemple le nombre d'heures passées ou le taux d'erreurs hebdomadaire actuel. Sans base de référence, dire que « ça fonctionne » n'est qu'une opinion.
C'est l'étape que la plupart des projets pilotes ignorent. Constituez un jeu de test composé de cas réels et complexes, y compris les plus délicats, et exécutez-le à chaque modification du prompt, du modèle ou des données. Chez Imaginary Cloud, nous l'utilisons comme un filtre : un système d'IA doit réussir un jeu de test incluant des cas réels et des cas limites avant d'être mis en ligne. Continuez ensuite les tests après le lancement, car les données de production évoluent.
Optez pour la conception la plus simple qui fonctionne. Un agent d'IA est un logiciel qui utilise un modèle de langage pour décider et exécuter des étapes, comme consulter une commande ou rédiger une réponse. Commencez par un flux de travail fixe et n'ajoutez des étapes d'agent que là où le jugement est nécessaire. Assurez-vous que le modèle reste interchangeable afin qu'une mise à niveau ne nécessite pas une réécriture complète. Si vous n'êtes pas certain d'avoir besoin d'un agent, utilisez le test en cinq questions pour choisir entre un agent d'IA et une automatisation traditionnelle.
La gouvernance n'est ni un verrou binaire ni une liberté totale. Gartner avertit qu'appliquer des règles uniformes à chaque agent, indépendamment de son autonomie, est voué à l'échec, et prédit que 40 % des entreprises rétrograderont ou mettront hors service leurs agents autonomes d'ici 2027 car les failles ne font surface qu'après des incidents. Adaptez les contrôles au niveau d'autonomie.
Le NIST AI Risk Management Framework (gouverner, cartographier, mesurer, gérer) est une approche volontaire et une liste de contrôle pertinente, tandis que la norme ISO/IEC 42001 couvre le volet système de gestion. Pour les agents, le risque d'agence excessive de l'OWASP est l'approche pragmatique : limitez les autorisations et exigez une approbation humaine pour les actions irréversibles.
Les modèles ne s'exécutent pas tout seuls. Vous avez besoin de CI/CD (tests automatisés et pipelines de déploiement), d'infrastructure en tant que code, de journalisation, de surveillance et d'un responsable désigné pour le système en production. Cette responsabilité est souvent appelée MLOps : les pratiques qui assurent le fonctionnement fiable des modèles de machine learning en production.
Le cadre de déploiement d'IA d'Imaginary Cloud le couvre en cinq étapes : évaluation de la préparation à la production, renforcement architectural, examen de conformité, responsabilité MLOps et déploiement progressif. Il existe parce qu'un prototype qui fonctionne lors d'une démonstration est très différent d'un système qui doit fonctionner un lundi matin.
Vos projets pilotes d'IA sont au point mort ? Notre équipe de services de développement d'IA peut examiner leur position par rapport à ces cinq couches et vous indiquer ce qui sépare chaque projet pilote de la mise en production.
Trois groupes construisent des usines d'IA. Les fournisseurs d'infrastructure tels que NVIDIA, Dell, HPE, Cisco et Supermicro vendent des conceptions validées. Les fournisseurs de cloud et les gouvernements construisent des sites vastes et souverains. Les entreprises et leurs équipes logicielles bâtissent le pipeline de livraison qui déploie les fonctionnalités d'IA, ce qui correspond à la version dont la plupart des organisations ont besoin.
Côté infrastructure, des offres packagées existent désormais chez Dell, HPE, Cisco avec Supermicro, et Nutanix, la plupart étant articulées autour de la technologie NVIDIA. Côté logiciel, presque toutes les entreprises qui déploient des fonctionnalités d'IA construisent une usine, qu'elles utilisent ce terme ou non. La différence réside dans le fait de le faire délibérément.
Une usine d'IA souveraine maintient les données, l'infrastructure et les opérations sous le contrôle direct de l'organisation, un point crucial pour les gouvernements et les secteurs réglementés. HPE positionne son usine d'IA souveraine comme un moyen de concevoir, déployer et gouverner l'IA tout en conservant un contrôle strict sur les données, l'infrastructure, les opérations et la conformité.
Pour la plupart des entreprises, ce niveau de contrôle n'est pas le point de départ. Une région cloud en laquelle vous avez déjà confiance suffit généralement, à condition de garder le modèle interchangeable et de respecter le RGPD dès que l'IA traite des données personnelles.
Deux projets publics illustrent à quoi ressemble la couche de livraison. Aucun des deux ne concerne les grands modèles de langage, et nous préférons le préciser plutôt que d'enjoliver la réalité.
Sedna. Sedna gère deux plateformes de communication pour les équipes de transport et de chaîne logistique. L'objectif était de réduire les coûts de ses flux d'intégration Tray.io et de diminuer sa dette technique. Imaginary Cloud a optimisé les flux existants, puis les a migrés vers des fonctions AWS Lambda personnalisées, avec une CI/CD pour les plugins de synchronisation de données et Terraform pour l'infrastructure. Un développeur backend et un développeur full-stack ont travaillé au sein de l'équipe de Sedna.
Le résultat publié représente une réduction de 80 % des coûts liés à Tray.io.
Il n'y a pas de machine learning dans cette étude de cas. (C'est notre interprétation, pas une déclaration de Sedna.) C'est la première étape d'une usine logicielle d'IA en action : se demander si le problème nécessite réellement l'IA. Les règles étaient connues, donc le code déterministe et une ingénierie de livraison solide l'ont emporté. Les mêmes habitudes — CI/CD, infrastructure as code et une équipe qui s'approprie le système en production — sont ce qui permet à une fonctionnalité d'IA de perdurer après son lancement.
Environmental Intellect. Ei dessert l'industrie du raffinage et des procédés. Imaginary Cloud a développé un module de machine learning qui détecte et étiquette automatiquement les objets dans un nuage de points 3D, puis a ajouté la détection de texte 3D. Ei affirme que ses clients peuvent économiser jusqu'à 200 000 $ en coûts de sous-traitance, de planification d'échafaudages et de vérification. La page n'attribue pas ce chiffre spécifiquement au module de ML, nous ne le faisons donc pas non plus.
Commencez petit et construisez le pipeline autour d'un cas d'usage réel. Choisissez le cas d'usage et son responsable, préparez les données, rédigez l'évaluation avant la fonctionnalité, choisissez l'architecture la plus simple, ajoutez une gouvernance proportionnelle à l'autonomie, puis déployez par phases et surveillez. Répétez l'opération avec le cas d'usage suivant en réutilisant ce que vous avez construit.
Chez Imaginary Cloud, chaque étape se termine par une porte : un contrôle qui doit être validé avant de passer à la suite. Nous appelons cela la méthode des six portes. Les portes sont l'élément que la plupart des guides pratiques omettent.
Le retour sur investissement se concrétise dès le deuxième cas d'usage. Il doit réutiliser les contrôles de données, le banc d'évaluation, les règles de gouvernance et le pipeline de déploiement du premier. Si ce n'est pas le cas, vous avez un projet, pas une usine.
Suivez trois indicateurs pour chaque cas d'usage : coût de développement, délai de mise en production et coût opérationnel mensuel. Dans une usine efficace, les cas d'usage deux et trois surpassent le premier sur ces trois points. Nous ne donnons pas de chiffre type pour les économies réalisées sur le second cas, car cela dépend de votre capacité de réutilisation : mesurez-le.
Pour tester la rentabilité d'un cas d'usage, utilisez une formule simple issue de notre guide sur les agents IA. La valeur nette mensuelle correspond aux heures économisées multipliées par le coût horaire chargé, plus les erreurs évitées multipliées par le coût par erreur, moins les coûts d'inférence, d'infrastructure, de supervision et de maintenance. Le délai de récupération en mois est égal au coût de développement divisé par la valeur nette mensuelle.
Il n'existe pas de calendrier unique honnête, car une usine à IA est quelque chose que l'on accumule, pas quelque chose que l'on termine. Fixez un point de preuve pour chaque cas d'usage dans un délai d'environ 90 jours, comme le recommande Gartner pour les investissements en IA, et laissez les composants réutilisables se développer à chaque étape. Un premier cas d'usage nécessite une petite équipe centrale, pas un département entier.
Gartner recommande d'exiger des points de preuve à 90 jours pour les investissements en IA afin de maîtriser les coûts. Pour un premier cas d'usage, nous estimons que quatre rôles sont nécessaires : un responsable métier, un garant des données, des ingénieurs assurant l'exploitation du système en direct, et un responsable de la sécurité ou des risques. Une même personne peut assumer plusieurs rôles dans une petite entreprise.
À titre d'exemple de livraison, le projet Sedna d'Imaginary Cloud a mobilisé deux développeurs intégrés, un backend et un full-stack. Il s'agissait d'un projet d'automatisation, pas d'un agent IA ; voyez cela comme un exemple d'équipe de livraison agile, pas comme une règle absolue.
Il est trop tôt pour une usine à IA si vous n'avez qu'un seul cas d'usage, aucun responsable désigné et aucune base de données de référence. Dans ce cas, construisez un bon projet en respectant les six gates et arrêtez-vous là. L'usine commence à être rentable lorsqu'un second cas d'usage réutilise les contrôles de données, l'évaluation et le pipeline de déploiement du premier.
Trois signes indiquent que vous n'êtes pas prêt pour une usine, et ces trois points reflètent notre vision :
Les petites équipes peuvent gérer une usine logicielle d'IA sans infrastructure supplémentaire. Les six étapes exigent de la discipline, pas du matériel.
Achetez lorsque le cas d'usage est courant et qu'un fournisseur le résout déjà. Développez en interne si l'IA est au cœur de votre produit et que vous disposez d'ingénieurs capables de l'exploiter en production. Faites appel à un partenaire lorsque le flux de travail est spécifique à votre entreprise et couvre plusieurs systèmes. Quel que soit votre choix, nommez un responsable et conservez les connaissances en interne.
| Option | Idéal quand | Points de vigilance |
|---|---|---|
| Acheter | Le problème est courant et la rapidité compte | Limites du fournisseur et frais récurrents |
| Développer en interne | L'IA est centrale et vous avez les ingénieurs | Démarrage lent et coût de compétences rares |
| Faire appel à une équipe | Le flux de travail est spécifique et traverse plusieurs systèmes | Dépendance vis-à-vis du partenaire |
Ce dernier risque est bien réel, et comme nous sommes nous-mêmes un partenaire, nous le dirons clairement. Gartner prévoit que d'ici 2028, 70 % des entreprises abandonneront l'IA agentique construite par les ingénieurs détachés des fournisseurs, piégées par les coûts et incapables de faire évoluer la solution par elles-mêmes. La solution est contractuelle et pratique : exigez la propriété du code, la documentation et la collaboration de vos propres ingénieurs avec les nôtres dès la première semaine.
Côté infrastructure, nous pensons que posséder des GPU ne se justifie que pour des raisons de souveraineté, de réglementation ou de volume d'inférence très élevé et constant. Pour la plupart des équipes, la location de capacité est plus simple.
Il n'existe pas de chiffre unique honnête. Les coûts d'infrastructure dépendent des GPU, de l'énergie, du refroidissement et des licences logicielles ; demandez donc aux fournisseurs un coût total de possession. Pour l'usine logicielle, les fourchettes publiées par les agences situent un premier cas d'usage cadré entre 50 000 et 250 000 dollars, et une plateforme multi-systèmes personnalisée entre 500 000 et 1 million de dollars, voire plus.
Ces chiffres proviennent de Nomtek, et Kanerika dresse un tableau similaire : une preuve de concept viable à partir d'environ 25 000 dollars, et une plateforme d'entreprise pouvant dépasser le million de dollars une fois la gouvernance, les intégrations et le déploiement pris en compte. Kanerika ajoute, en citant TechAhead, que l'intégration et les tests de qualité représentent généralement 40 à 60 % du coût de développement des projets d'entreprise. Considérez tout cela comme une orientation, pas comme un devis. Il s'agit d'agences, dont certaines sont nos concurrentes.
Ce qui compte plus que la fourchette, c'est la structure de la facture. DS Stream soutient que la puissance de calcul est le poste le plus visible et le plus facile à remplacer, tandis que les coûts durables résident dans le travail sur les données, les intégrations, la gouvernance et la maintenance. Trois facteurs influencent principalement votre budget : le nombre de systèmes avec lesquels l'IA interagit, l'état de vos données et votre périmètre réglementaire.
Divisez le budget en deux. Le coût de construction correspond au travail ponctuel nécessaire pour mettre en service un cas d'usage. Le coût de fonctionnement commence dès la première mise en production et couvre la surveillance, le réentraînement, les mises à jour des modèles, les revues de conformité et la gestion des incidents.
Ajoutez une marge de sécurité de 20 % à 30 % aux estimations personnalisées, comme le suggère Microsoft (via la même analyse de DS Stream). Traiter un programme d'IA comme un simple projet occulte les coûts de fonctionnement, et c'est là que les budgets s'épuisent.
Une usine à IA désigne deux choses sous un même nom. La version infrastructure est un centre de données spécialisé que vous pouvez acheter. La version logicielle est un modèle opérationnel que vous devez construire, car Gartner prévoit que plus de 40 % des projets d'IA agentique seront abandonnés d'ici fin 2027 pour des raisons de coût, de valeur et de risque.
Elle repose sur cinq piliers : des données prêtes à l'emploi, une évaluation avant les fonctionnalités, les agents ou modèles les plus simples possibles, une gouvernance proportionnelle à l'autonomie, et une livraison avec un responsable identifié. Commencez par un cas d'usage, franchissez les six étapes, et jugez l'usine à sa capacité à rendre le deuxième cas d'usage moins coûteux et plus rapide que le premier.
Les fournisseurs d'infrastructure tels que NVIDIA, Dell, HPE, Cisco, Supermicro et Nutanix vendent des conceptions d'usines à IA et des systèmes packagés, tandis que les fournisseurs de cloud et les gouvernements construisent de grands sites souverains. Au sein des entreprises, les équipes logicielles et produit construisent l'autre type : le pipeline qui fait passer l'IA du stade de pilote à celui de production. La plupart des organisations ont besoin de cette seconde version plutôt que de leur propre centre de données.
Un fournisseur de cloud vous loue une capacité de calcul et des services. Une usine à IA est la manière dont vous utilisez cette capacité pour déployer de l'IA de façon répétée. Dans le sens logiciel, vous pouvez faire fonctionner votre usine à IA sur un fournisseur de cloud et louer des GPU selon vos besoins. Dans le sens infrastructure, certains fournisseurs exploitent eux-mêmes des usines à IA et en vendent l'accès.
Il n'existe pas de calendrier unique et honnête, car l'usine se développe avec chaque cas d'usage plutôt que de se terminer à une date précise. Un objectif raisonnable est d'obtenir une preuve de concept en 90 jours environ pour chaque cas d'usage, en suivant les conseils de Gartner sur les investissements en IA. Le premier cas d'usage permet de mettre en place les contrôles de données, l'évaluation et le pipeline de mise en production que les suivants réutiliseront.
Un premier cas d'usage nécessite une petite équipe centrale couvrant quatre rôles : un responsable métier, une personne responsable des données, des ingénieurs qui exploitent le système en production, et un responsable de la sécurité ou des risques. Dans une petite entreprise, une seule personne peut occuper plusieurs rôles. Adaptez la taille de l'équipe à mesure que vous ajoutez des cas d'usage, et non avant d'en avoir un deuxième.
Il est trop tôt si vous n'avez qu'un seul cas d'usage, aucun responsable identifié et aucune base de données de référence. Dans ce cas, menez plutôt un projet bien gouverné à travers les six étapes. Une usine à IA commence à être rentable lorsqu'un deuxième cas d'usage réutilise les contrôles de données, l'évaluation et le pipeline de mise en production du premier ; attendez donc d'en avoir un en vue.
Oui, dans le sens logiciel, et vous pouvez commencer par un seul cas d'usage. Choisissez un problème, un responsable et un indicateur de succès, puis construisez les contrôles de données, l'évaluation et le pipeline de mise en production autour de celui-ci. Construire le type infrastructure, avec vos propres GPU, est pertinent pour des raisons de souveraineté ou pour un volume très élevé et constant. Sinon, louez la capacité.
Déterminez si le problème nécessite réellement l'IA. Le test en cinq questions d'Imaginary Cloud examine cinq domaines : les étapes, les entrées, les exceptions, le jugement et les systèmes. Si quatre ou cinq réponses pointent vers des règles connues, l'automatisation traditionnelle est moins coûteuse, plus rapide et plus facile à auditer. Si elles pointent vers un travail complexe et variable, un système d'IA mérite une attention sérieuse, et les six portes d'accès entrent alors en jeu.
Des proches parents, mais pas des jumeaux. Le MLOps (les pratiques qui maintiennent les modèles de machine learning en production) et les plateformes d'IA sont des outils. Une usine d'IA logicielle ajoute les décisions entourant ces outils : quels cas d'usage poursuivre, comment les évaluer, qui les gouverne et qui en est responsable une fois en service. Une entreprise peut posséder les outils et manquer tout de même de l'usine.
Si vous avez un projet pilote qui fonctionne mais aucune voie claire vers la production, c'est précisément sur cet écart que nous travaillons. Discutez avec nous du passage de votre projet pilote à la production, ou parcourez nos études de cas associées pour voir comment nous livrons nos résultats.
Alexandra Mendes est Senior Growth Specialist chez Imaginary Cloud et possède plus de 3 ans d'expérience dans la rédaction sur le développement logiciel, l'IA et la transformation numérique. Après avoir suivi une formation en développement frontend, Alexandra a acquis des compétences pratiques en programmation et travaille désormais en étroite collaboration avec les équipes techniques. Passionnée par la manière dont les nouvelles technologies façonnent les entreprises et la société, Alexandra aime transformer des sujets complexes en contenus clairs et utiles pour les décideurs.
People who read this post, also found these interesting: