Written by:

Last Published:
14 octobre 2026
•

Cherchez les meilleurs assistants de codage IA et vous trouverez des centaines de classements, principalement constitués de listes de fonctionnalités. Une bonne partie est rédigée par les fournisseurs eux-mêmes, ce qui revient un peu à demander au boulanger quel est le meilleur pain.
Voici donc la réponse que nous donnerions à un ami. GitHub Copilot, Cursor, Claude Code et OpenAI Codex sont tous performants, mais aucun ne domine partout. Copilot convient aux équipes qui travaillent principalement sur GitHub, Cursor à celles qui souhaitent des agents intégrés à l'éditeur, et Claude Code à celles qui privilégient le terminal.
La vraie question est de savoir ce qui se passe une fois que l'outil a généré le code. Les équipes d'ingénierie n'achètent pas des fonctionnalités, elles achètent une charge de revue, car chaque ligne écrite par un assistant finit dans une pull request qu'un ingénieur senior doit lire et valider.
Ce guide compare ces quatre outils du point de vue d'une équipe qui déploie des logiciels en production, en précisant où chacun apporte une aide et où il nécessite une revue par un senior.
Un assistant de codage IA est un logiciel utilisant des modèles de langage étendus pour suggérer, écrire, expliquer ou modifier du code. En 2026, la catégorie s'est scindée en deux : les assistants qui suggèrent pendant que vous travaillez, et les agents qui prennent un objectif en charge et œuvrent pour l'atteindre. Gartner évalue désormais ce second groupe séparément, en tant que agents de codage IA pour entreprises.
Considérez un assistant intégré comme un GPS : il suggère le prochain virage et vous gardez les mains sur le volant. Un agent est un taxi : vous indiquez la destination et jugez l'itinéraire à l'arrivée. Les deux vous mènent à bon port, mais la couverture d'assurance n'est pas la même.
L'adoption n'est plus le sujet du débat. L'enquête 2026 de Stack Overflow auprès des développeurs a révélé que 66 % des répondants utilisent des assistants ou des agents de codage, et que 73 % de ces utilisateurs les emploient quotidiennement. C'est la confiance qui fait débat : 48 % ont déclaré ne faire confiance aux résultats de l'IA que lorsqu'ils peuvent facilement les vérifier, et seuls 6,6 % leur feraient confiance pour des décisions importantes.
Nous avons évalué chaque outil selon quatre critères essentiels pour une équipe plutôt que pour un individu : où il permet un gain de temps réel, où il exige une relecture par un senior, quels contrôles sont offerts à l'administrateur, et comment la facture évolue en cas d'utilisation intensive. C'est l'angle d'approche dont un responsable technique a besoin pour choisir parmi les meilleurs assistants de codage IA.
Notre page publique sur les pratiques en matière d'IA présente Cursor comme notre environnement principal, aux côtés de Claude, GitHub Copilot et Gemini. La capacité des assistants à faire gagner du temps ou à nécessiter une relecture dépend davantage de la tâche que de l'outil ; ces deux critères font donc l'objet de sections dédiées ci-dessous. Le tableau suivant indique quelles entrées proviennent de notre propre stack et lesquelles sont issues de la documentation, de rapports d'analystes et de recherches publiées. Il s'agit d'une comparaison de praticiens, et non d'un test en laboratoire ; vérifiez donc les tarifs et les conditions de chaque fournisseur avant tout engagement.
GitHub Copilot, Cursor, Claude Code et OpenAI Codex figurent tous dans le haut du panier, sans qu'aucun ne domine sur tous les plans. Faites votre choix en fonction de l'environnement de travail actuel de votre équipe, du degré d'autonomie que vous souhaitez accorder et des exigences de vos responsables sécurité. Ce sont ces trois contraintes qui déterminent le meilleur choix, et non la liste des fonctionnalités.
Le Magic Quadrant de Gartner de mai 2026 pour les agents de codage IA d'entreprise a désigné Anthropic, Cursor, GitHub et OpenAI comme leaders. Le statut de leader indique qu'un fournisseur est sérieux, mais ne garantit pas qu'il est adapté à votre équipe.
| GitHub Copilot | Cursor | Claude Code | OpenAI Codex | |
|---|---|---|---|---|
| Forme | Assistant et agents, intégrés à GitHub et aux IDE courants | Éditeur natif IA avec agents, y compris des agents cloud | Agent pour le terminal, l'IDE, l'application de bureau et le navigateur | Agent de codage d'OpenAI |
| Idéal pour | Équipes dont le code, les revues et la CI sont déjà sur GitHub | Développeurs souhaitant des agents directement dans l'éditeur | Équipes privilégiant le terminal et souhaitant un agent scriptable | Organisations déjà standardisées sur OpenAI |
| Contrôles à vérifier | Politiques d'organisation, quota de crédits IA, et revue de code consommant aussi des minutes Actions | Mode confidentialité imposé à l'échelle de l'organisation, rapport SOC 2 Type II sur demande, exceptions pour les clés API personnelles et certains modèles | Paramètres gérés, application des politiques, suivi de l'utilisation et hébergement via AWS ou Google Cloud | Conditions entreprise et traitement des données : à confirmer directement auprès d'OpenAI |
| Comment nous le connaissons | Dans notre stack, utilisé comme premier relecteur | Notre environnement principal, utilisé sur Orizion | Documentation et rapports d'analystes (les modèles Claude font partie de notre stack) | Documentation et rapports d'analystes |
GitHub Copilot est l'option la plus fluide pour les équipes dont les dépôts, les pull requests et l'intégration continue (CI) sont déjà hébergés sur GitHub. Il s'intègre directement au flux de travail existant, ce qui accélère son déploiement. La contrepartie réside dans la visibilité des coûts, la facturation étant passée d'un décompte de requêtes à une consommation mesurée.
GitHub affirme avoir été nommé leader par Gartner pour la troisième année consécutive. Depuis le 1er juin 2026, les unités de requête premium ont été remplacées par des crédits GitHub AI, et la revue de code par Copilot consomme également des minutes GitHub Actions. Un bot de revue, deux compteurs. Dans notre stack, Copilot sert de premier niveau de revue, mais un bot qui analyse le travail d'un autre bot a tendance à partager ses angles morts.
Cursor est un éditeur conçu pour l'IA et articulé autour d'agents ; c'est notre environnement principal chez Imaginary Cloud. Il mérite cette place pour son travail de conversion du design en code. Il s'accompagne toutefois d'une note de bas de page liée aux achats en 2026, car son actionnariat a changé en août et vos conditions relatives aux données méritent une relecture.
Sur Orizion, nos ingénieurs ont utilisé Cursor avec le serveur MCP de Figma (le Model Context Protocol, un standard ouvert permettant aux outils d'IA de se connecter à d'autres logiciels, ici les fichiers de design Figma) pour transformer des designs en composants React et en exigences API, avec une revue de code manuelle rigoureuse à chaque étape. L'équipe a réduit l'usage de Figma Make, qui s'est avéré plus utile pour l'idéation que pour la production de designs prêts à l'emploi.
Venons-en maintenant à la note de bas de page. SpaceX a finalisé l'acquisition de la société mère de Cursor, Anysphere, le 14 août 2026. Cela ne fait pas de Cursor un mauvais choix, mais c'est le moment idéal pour relire vos conditions relatives aux données. Cursor précise que le mode confidentialité peut être imposé par un administrateur sans conditions de conservation des données associées, bien que son guide de renforcement de la sécurité indique que les clés API personnelles et les modèles avec conservation des données côté fournisseur ne sont pas couverts par ces engagements.
Claude Code est l'agent de codage d'Anthropic, disponible dans le terminal, l'IDE, l'application de bureau et le navigateur. Il est idéal pour les équipes qui recherchent un agent scriptable pouvant être intégré à leurs flux de travail existants. Sa documentation administrateur couvre la gestion des paramètres, l'application des politiques et le suivi de l'utilisation.
La documentation d'Anthropic précise qu'il peut être exécuté via sa propre API ou hébergé sur AWS ou Google Cloud, ce qui est pertinent si votre service achats dispose déjà d'un accord cloud. Les modèles Claude font partie de notre stack, mais cette entrée repose sur la documentation et l'évaluation de Gartner plutôt que sur nos propres tests.
Codex d'OpenAI est le quatrième fournisseur nommé Leader par Gartner en mai 2026, et il mérite d'être intégré à votre phase pilote si vous possédez déjà un contrat entreprise OpenAI. Cette entrée s'appuie sur la documentation et les rapports d'analystes, et non sur nos propres travaux de mise en œuvre. Windsurf, ainsi que les offres AWS et Google, méritent d'être étudiés si votre stratégie cloud s'oriente dans cette direction.
Dans son rapport de 2026, Gartner classe AWS et Google parmi les Challengers, rappelant que les définitions de catégories évoluent presque aussi vite que les produits eux-mêmes.
Le choix entre Cursor et GitHub Copilot se résume à une question d'éditeur versus écosystème, tandis que Claude Code face à Copilot oppose un agent de terminal à un assistant natif GitHub. Le choix entre Cursor et Claude Code dépend principalement de l'environnement de travail préféré de vos ingénieurs. Choisissez d'abord en fonction du flux de travail, puis vérifiez les conditions relatives aux données.
Les assistants de codage IA sont les plus utiles lorsque la réponse est facile à vérifier : code répétitif (boilerplate), squelettes de tests, refactorisation avec une couverture de tests solide et explication de code inconnu. Ils sont les moins utiles lorsque la justesse dépend d'un contexte non documenté, comme les règles métier, les autorisations et les migrations de données.
Les développeurs semblent en être conscients. Selon les données de Stack Overflow, les utilisateurs ont recours à l'IA principalement pour du code familier (67 %) et le débogage (61 %), et seulement 20 % l'utilisent pour le déploiement, l'exploitation ou le dépannage de systèmes en production. Orizion illustre bien cette tendance : l'équipe a rédigé un backlog de conception et une documentation Figma avec des notes comportementales, offrant ainsi aux développeurs comme aux outils d'IA une base explicite sur laquelle travailler. Des scripts chargeant des comptes de test pré-remplis de données ont ensuite permis de tester les fonctionnalités limitées dans le temps sur l'environnement de staging, sans engendrer de coûts réels sur Stripe.
Si vous en êtes encore au stade du prototype, notre article sur les risques du « vibe coding » pour les logiciels en production aborde le fossé qui sépare une démonstration d'une mise en production.
Le code généré par IA nécessite une revue par un développeur senior dès lors qu'une erreur peut s'avérer coûteuse ou invisible : authentification, paiements, autorisations, migrations de données, modifications de dépendances et tout ce qui touche aux données réglementées. Un code qui compile et réussit ses propres tests n'est pas nécessairement sûr, car ces tests sont souvent rédigés par le même assistant.
Le rapport 2026 GenAI Code Security Report de Veracode a révélé que le code généré échouait aux tests de sécurité dans environ 44 % des cas en l'absence de directives spécifiques, bien que la syntaxe soit quasi parfaite. (Veracode commercialise des solutions de tests de sécurité et a testé des modèles bruts ; il faut donc interpréter ces résultats comme une absence de supervision, et non comme une fatalité.) Les recherches de DORA en 2025, issues du programme de longue date DevOps Research and Assessment de Google, qualifient l'IA d'amplificateur : son adoption est désormais corrélée à une augmentation du débit de livraison, mais aussi à une instabilité accrue.
Le chiffre de vitesse le plus connu a également mal vieilli. L'essai de METR en 2025, gérée par une organisation à but non lucratif indépendante de recherche en IA, a révélé que 16 développeurs expérimentés ont mis 19 % de temps en plus avec l'IA tout en pensant être 20 % plus rapides. METR considère désormais ces données comme historiques, car ses données de suivi de 2026 n'étaient pas fiables. Personne ne peut vous fournir un chiffre unique et digne de confiance. Méfiez-vous de quiconque prétend le faire.
Alors, que doit faire une équipe ? Appliquez ce que nous appelons l'Échelle de Revue : plus le coût de l'erreur est élevé, plus le relecteur doit être expérimenté.
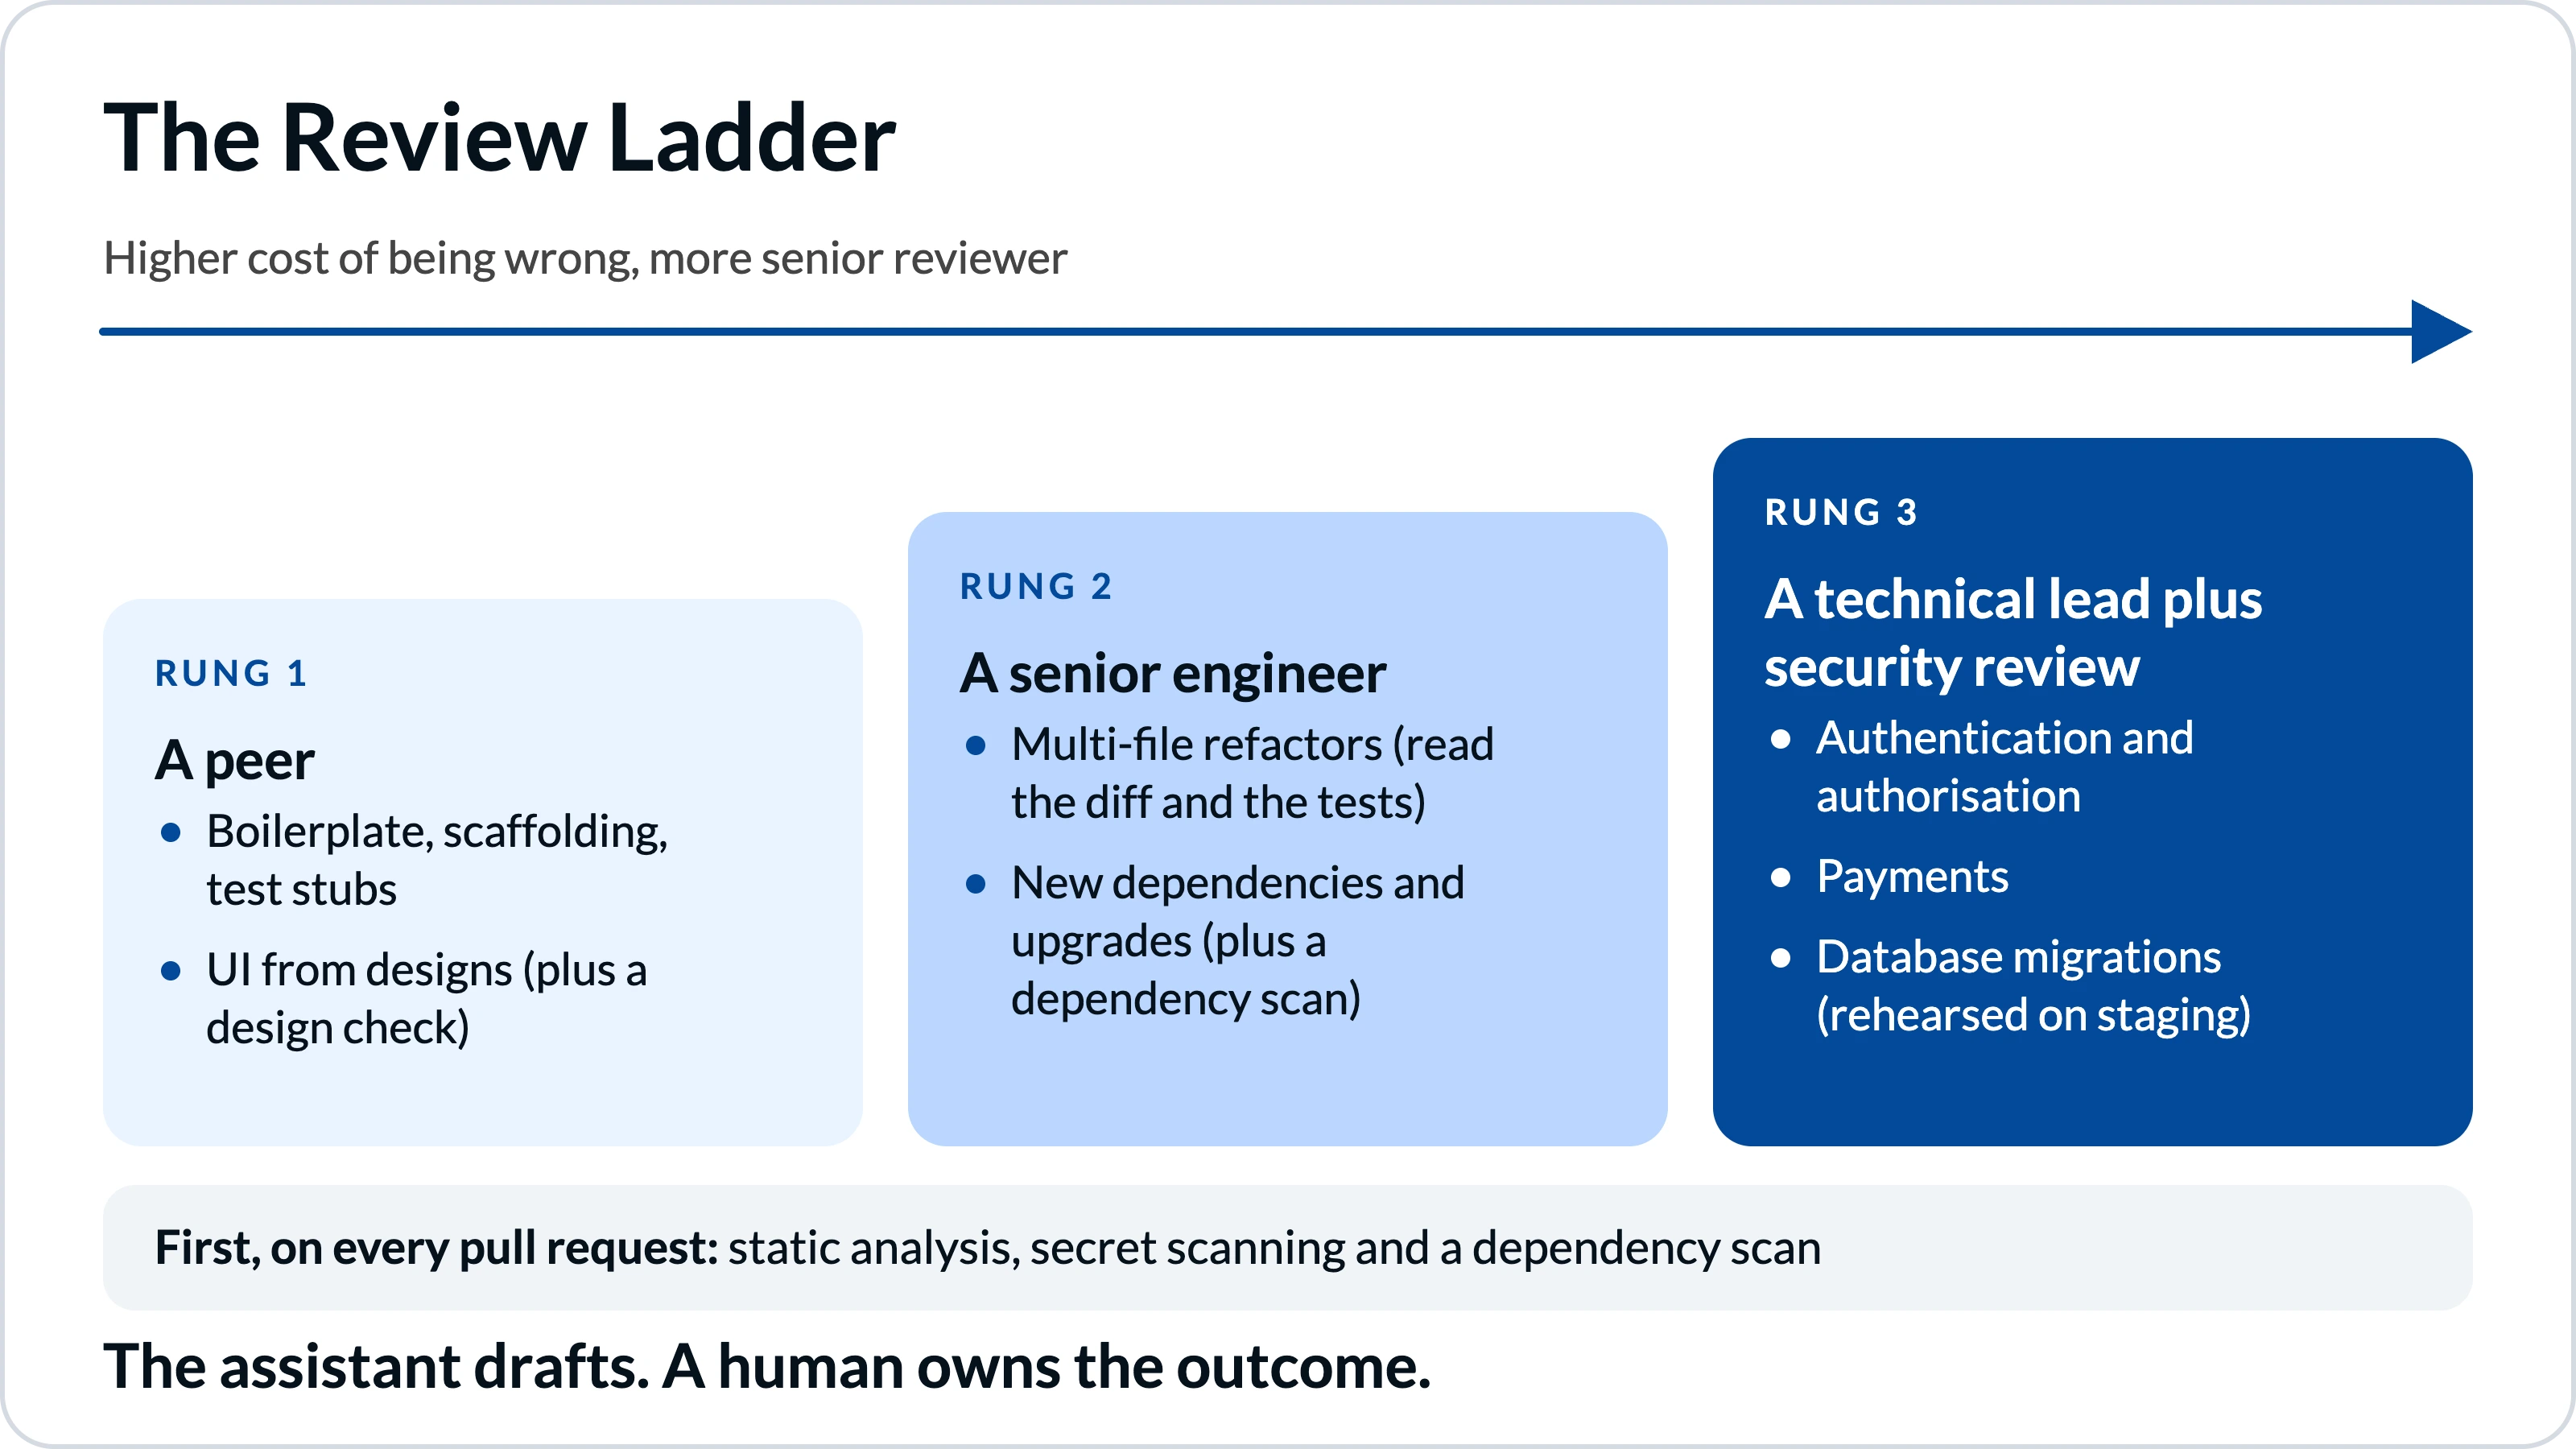
Adaptez l'Échelle de Revue à votre propre niveau de risque. Le principe reste le même : l'assistant rédige, un humain assume la responsabilité du résultat.
Un contrôle efficace repose sur trois piliers : des vérifications automatisées avant toute intervention humaine, un relecteur qui comprend le système, et une personne nommément responsable de ce qui est fusionné. La rapidité vient du premier point. La sécurité dépend des deux autres, et aucune de ces responsabilités ne peut être déléguée à l'assistant.
Dans nos propres processus de livraison, aucun code n'atteint la production sans une demande de fusion (pull request) validée, et cette fusion nécessite l'approbation explicite d'un responsable technique. Il vérifie la conformité de la sécurité, l'alignement architectural et la logique métier complexe pour chaque demande de fusion générée par un agent, et ce même contrôle est appliqué à notre développement sur mesure assisté par IA . Si vous mettez en place votre propre système de contrôle, quatre habitudes s'avèrent rapidement payantes :
Les outils de revue de code par IA, tels que Copilot code review et Bugbot de Cursor, sont plus efficaces en tant que premier filtre pour détecter les défauts évidents avant qu'un humain ne lise la pull request. Ils ne remplacent pas le relecteur et représentent un coût supplémentaire.
Utilisez les outils de revue de code par IA pour accélérer la relecture humaine, et non pour décider si cette relecture doit avoir lieu.
Choisissez les meilleurs assistants de codage par IA pour votre équipe en fonction de vos contraintes plutôt que de benchmarks, puis gérez-les comme n'importe quel changement technique : testez-les avec un petit groupe, formalisez la politique par écrit et mesurez les résultats que vous suivez déjà. Sans cela, les licences vous offrent une vitesse que vous ne pouvez pas exploiter en toute sécurité.
Quatre questions permettent de restreindre le choix plus rapidement que n'importe quel tableau comparatif :
Menez un projet pilote de quatre semaines avec une ou deux équipes volontaires sur des tickets réels, soumettez les mêmes trois tâches à chaque outil et notez ce que les relecteurs ont dû corriger. Ce registre deviendra votre politique et votre matériel de formation. La gouvernance est au cœur de toute revue de sécurité en entreprise concernant les outils de codage par IA, et seuls 24 % des développeurs ont déclaré que leur organisation avait publié une liste d'outils approuvés ou une politique officielle en matière d'IA.
Dans les secteurs réglementés, traitez un assistant de codage par IA comme n'importe quel fournisseur ayant accès à votre code : demandez son rapport SOC 2, ses conditions de conservation, ses journaux d'audit et ses options de résidence des données, et placez les données réglementées sur le niveau le plus strict de l'échelle de revue. Prévoyez ensuite des changements de modèle, car le modèle derrière votre assistant peut évoluer.
Demandez à chaque fournisseur quel préavis vous est accordé avant qu'un modèle ne soit retiré ou remplacé, et relancez vos trois tâches pilotes après tout changement majeur. Si un résultat nécessite soudainement plus de relecture, vous préférez le découvrir lors d'un projet pilote plutôt qu'en production.
Le coût réel d'un assistant de codage IA comprend les licences, l'utilisation, la dépendance vis-à-vis du fournisseur et le temps de revue ; ce dernier est le poste de dépense que la plupart des budgets oublient. Le retour sur investissement dépend donc de la capacité de votre équipe à absorber une rédaction plus rapide, et non de la vitesse à laquelle l'outil génère du code.
Les licences constituent le coût visible. Les crédits d'utilisation, les minutes consacrées à la revue de code et les heures passées par les seniors à relire les pull requests générées par l'IA ne le sont pas, et depuis le 1er juin 2026, la facturation de Copilot est basée sur la consommation. Soyez sceptique face à tout chiffre de rentabilité et mesurez le vôtre : suivez le délai de livraison (lead time), le taux d'échec des changements et le taux de retravail avant et après le projet pilote. Si le débit augmente et que les échecs restent stables, vous avez un argument commercial ; si les deux augmentent, vous avez acheté de la vitesse au prix de l'instabilité.
Évaluez ensuite le coût d'un incident selon vos propres critères, des heures d'ingénierie à l'impact client et à l'exposition lors des audits, puis comparez-le à une année de licences avant de décider du budget à allouer à la capacité de revue. Concernant la dépendance, évitez les contrats plus longs que votre horizon de planification et assurez-vous de savoir à quelle vitesse vous pourriez changer de solution.
Pour présenter cela à une direction ou à un comité d'achat, limitez le dossier à une page : le problème, un projet pilote de quatre semaines avec les indicateurs de livraison mentionnés plus haut comme critères de succès, le coût incluant la capacité de revue, le plan de sortie et une date de décision. Cela répond également à la question du délai de rentabilité : une décision de poursuivre ou non en moins d'un mois, et non d'un an.
Il n'existe pas de solution unique, car le bon choix dépend de l'environnement de travail de votre équipe. GitHub Copilot convient aux équipes structurées autour de GitHub, car il s'intègre aux issues, aux pull requests et aux Actions. Cursor est adapté aux équipes qui souhaitent des agents directement dans l'éditeur, et Claude Code aux équipes privilégiant le terminal et les agents scriptables. Testez deux outils sur des tâches réelles pendant un mois, puis décidez en fonction de la charge de revue, du contrôle des données et du coût.
Aucun n'est meilleur dans l'absolu. Copilot est profondément intégré aux issues, pull requests et Actions de GitHub, tandis que Cursor est un éditeur conçu autour d'agents. Les équipes standardisées sur GitHub commencent souvent par Copilot. Vérifiez les conditions de propriété et de données pour les deux.
Ils ont des approches différentes : Claude Code est un agent scriptable, tandis que Copilot est un assistant avec des agents intégrés à GitHub. Choisissez en fonction de votre flux de travail et des contrôles d'administration, et testez les deux si possible.
Aucun test indépendant ne permet de désigner un vainqueur pour votre base de code. Le benchmark de sécurité 2026 de Veracode a évalué un modèle OpenAI à 68 %, tandis que six des 11 modèles listés se situaient entre 50 % et 53 %, avec de fortes variations selon le langage. Soumettez les trois mêmes tâches réelles à chaque outil et comparez l'effort de revue nécessaire.
Oui, si votre capacité de revue peut absorber le surplus de code. Une petite équipe dispose de moins de relecteurs pour traiter le volume généré. Commencez par un seul outil, gardez des pull requests de petite taille et mesurez le taux d'échec des changements ainsi que le taux de retravail sur un projet pilote de quatre semaines avant d'étendre l'usage.
Non. Les tests de Veracode en 2026 ont révélé qu'environ 44 % du code généré échouait aux tests de sécurité en l'absence de directives spécifiques, et DORA associe l'adoption de l'IA à une instabilité accrue des livraisons. Utilisez la revue par IA comme premier filtre, puis maintenez une personne responsable pour chaque fusion.
Appliquez les contrôles de confidentialité du fournisseur à l'échelle de l'organisation, lisez les exceptions et rédigez une politique interne. Cursor, par exemple, permet aux administrateurs d'imposer le mode confidentialité (Privacy Mode), mais les clés API personnelles et certains modèles ne sont pas couverts par ses conditions de non-rétention des données.
Le prix des licences n'est qu'une partie de l'équation. GitHub a fait passer Copilot à une facturation basée sur l'usage le 1er juin 2026 ; une utilisation intensive des agents peut donc dépasser le crédit alloué par votre forfait. Prévoyez un budget pour vos utilisateurs les plus actifs et pour la revue de code, et réévaluez vos tarifs chaque trimestre.
Les meilleurs assistants de codage par IA sont ceux que vos relecteurs peuvent suivre sans être débordés. GitHub Copilot, Cursor, Claude Code et OpenAI Codex méritent tous une phase de test. Le choix dépendra de l'environnement de travail de votre équipe, des données susceptibles de sortir de votre réseau et du degré d'autonomie que vous souhaitez accorder. Les faits montrent que l'IA accélère la rédaction, mais pas le jugement : le code généré échoue toujours aux tests de sécurité, l'instabilité des livraisons augmente et personne ne dispose de chiffres de productivité fiables. Suivez donc notre « échelle de revue », testez deux outils pendant quatre semaines, mesurez vos propres résultats et formalisez votre politique.
Si vous procédez ainsi, l'assistant deviendra un véritable multiplicateur de force. Si vous l'ignorez, vous aurez simplement déplacé le goulot d'étranglement vers les personnes que vous pouvez le moins vous permettre de ralentir.
Si votre équipe fusionne plus de code généré par IA que personne n'a le temps de lire, un audit de code est le moyen le plus rapide de découvrir ce qui se trouve réellement en production. L'audit de code d'Imaginary Cloud Audit de code examine la structure du code, sa qualité, les vulnérabilités de sécurité, les limites de scalabilité et la dette technique, tout en vous offrant une feuille de route claire pour corriger ce qui est prioritaire. Il s'inscrit dans notre offre plus large d' Audit technique et UX . Réservez un appel et nous vous indiquerons où porter votre attention.
Nous avons déjà réalisé des missions similaires : un audit de code pour TeachTutti, ainsi qu'une standardisation de code et une documentation architecturale pour GoodBarber.
Alexandra Mendes est Senior Growth Specialist chez Imaginary Cloud et possède plus de 3 ans d'expérience dans la rédaction sur le développement logiciel, l'IA et la transformation numérique. Après avoir suivi une formation en développement frontend, Alexandra a acquis des compétences pratiques en programmation et travaille désormais en étroite collaboration avec les équipes techniques. Passionnée par la manière dont les nouvelles technologies façonnent les entreprises et la société, Alexandra aime transformer des sujets complexes en contenus clairs et utiles pour les décideurs.
People who read this post, also found these interesting: