Written by:

Last Published:
14. Oktober 2026
•

Wer nach den besten KI-Coding-Assistenten sucht, findet hunderte Rankings, die meist nur aus Funktionslisten bestehen. Ein Großteil davon stammt von den Anbietern selbst – das ist in etwa so, als würde man den Bäcker fragen, welches Brot am besten schmeckt.
Hier ist also die Antwort, die wir einem Freund geben würden. GitHub Copilot, Cursor, Claude Code und OpenAI Codex sind allesamt gut, aber keiner von ihnen ist in jeder Hinsicht überlegen. Copilot eignet sich für Teams, die fest in GitHub verankert sind, Cursor für Teams, die Agenten direkt im Editor wünschen, und Claude Code für Teams, die hauptsächlich im Terminal arbeiten.
Die wichtigere Frage ist, was passiert, nachdem das Tool den Code geschrieben hat. Engineering-Teams kaufen keine Funktionen. Sie kaufen sich einen Review-Aufwand ein, denn jede Zeile, die ein Assistent schreibt, landet in einem Pull Request, den ein Senior Engineer prüfen und absegnen muss.
Dieser Leitfaden vergleicht die vier Tools aus der Perspektive eines Teams, das produktive Software ausliefert, und zeigt auf, wo die einzelnen Lösungen unterstützen und wo sie eine Prüfung durch erfahrene Entwickler erfordern.
Ein KI-Programmierassistent ist eine Software, die mithilfe großer Sprachmodelle Code vorschlägt, schreibt, erklärt oder ändert. Im Jahr 2026 hat sich die Kategorie in zwei Bereiche aufgeteilt: Assistenten, die während der Arbeit Vorschläge machen, und Agenten, die ein Ziel verfolgen und eigenständig darauf hinarbeiten. Gartner bewertet die zweite Gruppe mittlerweile separat als Enterprise-KI-Programmieragenten.
Stellen Sie sich einen Inline-Assistenten wie ein Navigationssystem vor. Er schlägt die nächste Abzweigung vor, aber Sie behalten die Hände am Steuer. Ein Agent ist wie ein Taxi: Sie nennen das Ziel und beurteilen die Route, wenn Sie ankommen. Beide bringen Sie ans Ziel, aber die Haftungsfrage ist eine andere.
Die Akzeptanz ist nicht mehr das Streitthema. Die Entwicklerumfrage 2026 von Stack Overflow ergab, dass 66 % der Befragten Programmierassistenten oder -agenten nutzen, wobei 73 % dieser Nutzer sie täglich einsetzen. Das eigentliche Streitthema ist das Vertrauen: 48 % gaben an, dass sie KI-Ergebnissen nur dann vertrauen, wenn sie diese leicht überprüfen können, und nur 6,6 % würden ihnen bei wichtigen Entscheidungen vertrauen.
Wir haben jedes Tool anhand von vier Kriterien bewertet, die für ein Team wichtiger sind als für den Einzelnen: Wo wird tatsächlich Zeit gespart, wo ist eine Überprüfung durch Senioren erforderlich, welche Kontrollmöglichkeiten hat ein Administrator und wie verhält sich die Kostenstruktur bei intensiver Nutzung. Das ist die Perspektive, die ein technischer Leiter bei der Auswahl der besten KI-Programmierassistenten einnehmen muss.
Unsere öffentliche KI-Praktiken -Seite führt Cursor als unsere primäre Umgebung auf, neben Claude, GitHub Copilot und Gemini. Wo Assistenten Zeit sparen und wo sie eine Überprüfung erfordern, hängt stärker von der Aufgabe als vom Tool ab; daher erhalten diese beiden Kriterien unten eigene Abschnitte. Die folgende Tabelle zeigt, welche Einträge aus unserem Stack stammen und welche aus Dokumentationen, Analystenberichten und veröffentlichten Studien. Dies ist ein Vergleich aus der Praxis, kein Labortest. Prüfen Sie daher die Preise und Bedingungen des jeweiligen Anbieters, bevor Sie etwas unterzeichnen.
GitHub Copilot, Cursor, Claude Code und OpenAI Codex gehören alle zur Spitzenklasse, aber keines ist in jeder Hinsicht überlegen. Treffen Sie Ihre Wahl basierend darauf, wo Ihr Team bereits arbeitet, wie viel Autonomie Sie zulassen wollen und was Ihre Sicherheitsverantwortlichen akzeptieren. Diese drei Faktoren entscheiden über die beste Lösung, nicht die Funktionsliste.
Im Gartner Magic Quadrant für Enterprise AI Coding Agents vom Mai 2026 wurden Anthropic, Cursor, GitHub und OpenAI als Leader eingestuft. Der Leader-Status zeigt Ihnen, dass ein Anbieter seriös ist. Er sagt jedoch nichts darüber aus, ob er auch zu Ihrem Team passt.
| GitHub Copilot | Cursor | Claude Code | OpenAI Codex | |
|---|---|---|---|---|
| Form | Assistent plus Agenten, integriert in GitHub und gängige IDEs | KI-nativer Editor mit Agenten, einschließlich Cloud-Agenten | Agent für Terminal, IDE, Desktop-App und Browser | Der Coding-Agent von OpenAI |
| Am besten geeignet für | Teams, deren Code, Reviews und CI bereits in GitHub liegen | Entwickler, die Agenten direkt im Editor wollen | Terminal-orientierte Teams, die einen skriptfähigen Agenten wollen | Organisationen, die bereits auf OpenAI standardisiert haben |
| Zu prüfende Kontrollen | Organisationsrichtlinien, AI-Credits-Kontingent und Code-Review, das zusätzlich Actions-Minuten verbraucht | Datenschutzmodus organisationsweit erzwungen, SOC-2-Type-II-Bericht auf Anfrage, Ausnahmen für persönliche API-Schlüssel und einige Modelle | Verwaltete Einstellungen, Richtliniendurchsetzung, Nutzungsüberwachung und Hosting über AWS oder Google Cloud | Enterprise-Bedingungen und Datenverarbeitung: direkt bei OpenAI bestätigen |
| Woher wir es kennen | In unserem Stack, als Reviewer der ersten Instanz im Einsatz | Unsere primäre Umgebung, eingesetzt bei Orizion | Dokumentation und Analystenberichte (Claude-Modelle sind Teil unseres Stacks) | Dokumentation und Analystenberichte |
GitHub Copilot ist die Lösung mit dem geringsten Implementierungsaufwand für Teams, deren Repositories, Pull Requests und CI bereits auf GitHub laufen. Da es sich nahtlos in den bestehenden Workflow einfügt, verkürzt sich die Einführungszeit. Der Nachteil ist die Kostentransparenz, da die Abrechnung von der Anzahl der Anfragen auf eine nutzungsbasierte Abrechnung umgestellt wurde.
GitHub gibt an, dass es zum dritten Mal in Folge als Gartner Leader ausgezeichnet wurde. Seit dem 1. Juni 2026 wurden Premium-Request-Einheiten durch GitHub AI Credits ersetzt, und die Copilot-Codeüberprüfung verbraucht zudem GitHub Actions-Minuten. Ein Reviewer-Bot, zwei Abrechnungsposten. In unserem Stack ist Copilot ein Reviewer der ersten Instanz, aber ein Bot, der die Ausgabe eines anderen Bots überprüft, neigt dazu, dieselben blinden Flecken zu haben.
Cursor ist ein KI-nativer Editor, der um Agenten herum aufgebaut ist, und unsere primäre Umgebung bei Imaginary Cloud. Er verdient sich diesen Platz durch seine Stärken bei der Umsetzung von Design in Code. Er ist jedoch mit einer Anmerkung für die Beschaffung im Jahr 2026 verbunden, da sich die Eigentumsverhältnisse im August geändert haben und Ihre Datenbedingungen eine erneute Prüfung verdienen.
Bei Orizionnutzten unsere Ingenieure Cursor mit dem Figma MCP-Server (dem Model Context Protocol, einem offenen Standard, der es KI-Tools ermöglicht, sich mit anderer Software zu verbinden, hier den Designdateien von Figma), um Designs in React-Komponenten und API-Anforderungen umzuwandeln, wobei durchgehend eine strikte manuelle Codeüberprüfung erfolgte. Das Team hat Figma Make wieder reduziert, da es sich für die Ideenfindung besser eignete als für produktionsreifes Design.
Nun zur Anmerkung. SpaceX hat die Übernahme von Cursors Muttergesellschaft Anysphere am 14. August 2026 abgeschlossen. Das macht Cursor nicht zu einer schlechten Wahl, aber es ist ein sinnvoller Zeitpunkt, um Ihre Datenbedingungen erneut zu lesen. Cursor gibt an, dass der Datenschutzmodus von einem Administrator erzwungen werden kann ohne dass dahinter Bedingungen zur Datenspeicherung stehen, obwohl der Leitfaden zur Sicherheitshärtung weist darauf hin, dass persönliche API-Schlüssel und Modelle mit anbieterseitiger Datenspeicherung nicht unter diese Verpflichtungen fallen.
Claude Code ist der Coding-Agent von Anthropic, der im Terminal, in der IDE, als Desktop-App und im Browser verfügbar ist. Er eignet sich für Teams, die einen Agenten suchen, den sie skripten und in bestehende Workflows integrieren können. Die Administrator-Dokumentation umfasst verwaltete Einstellungen, die Durchsetzung von Richtlinien sowie die Nutzungsüberwachung.
Die Dokumentation von Anthropic weist darauf hin, dass das Tool über die eigene API von Anthropic ausgeführt oder auf AWS oder Google Cloud gehostet werden kann – was relevant ist, falls die Beschaffungsabteilung bereits Cloud-Verträge abgeschlossen hat. Claude-Modelle sind Teil unseres Stacks, aber dieser Eintrag basiert auf Dokumentationen und der Einschätzung von Gartner und nicht auf unseren eigenen Tests.
OpenAI Codex ist der vierte Anbieter, den Gartner als Leader eingestuft hat im Mai 2026. Er sollte in Ihre Pilotphase einbezogen werden, falls Sie bereits einen Enterprise-Vertrag mit OpenAI haben. Dieser Eintrag stützt sich auf Dokumentationen und Analystenberichte, nicht auf unsere eigene Implementierungsarbeit. Windsurf sowie die Angebote von AWS und Google sind einen Blick wert, falls Ihre Cloud-Strategie in diese Richtung weist.
In seinem Bericht von 2026 ordnet Gartner AWS und Google als „Challenger“ ein – eine Erinnerung daran, dass sich Kategoriedefinitionen fast so schnell ändern wie die Produkte selbst.
Bei Cursor vs. GitHub Copilot geht es um Editor versus Ökosystem, bei Claude Code vs. Copilot um einen Terminal-Agenten versus einen GitHub-nativen Assistenten. Cursor vs. Claude Code ist primär eine Frage dessen, wo Ihre Entwickler am liebsten arbeiten. Entscheiden Sie zuerst nach dem Workflow und prüfen Sie anschließend die Datenbedingungen.
KI-Programmierassistenten sind dort am hilfreichsten, wo sich Ergebnisse leicht überprüfen lassen: bei Boilerplate-Code, Test-Gerüsten, Refactorings mit hoher Testabdeckung und der Erklärung von unbekanntem Code. Am wenigsten hilfreich sind sie dort, wo die Korrektheit von nicht dokumentierten Kontexten abhängt, wie etwa bei Geschäftsregeln, Berechtigungen und Datenmigrationen.
Entwickler scheinen sich dessen bewusst zu sein. Laut den Daten von Stack Overflow nutzen Anwender KI hauptsächlich für vertrauten Code (67 %) und beim Debugging (61 %). Nur 20 % setzen sie für das Deployment, den Betrieb oder die Fehlerbehebung in Produktionssystemen ein. Orizion verdeutlicht dieses Muster: Das Team erstellte ein Design-Backlog und eine Figma-Dokumentation mit Verhaltenshinweisen, sodass sowohl Entwickler als auch KI-Tools eine explizite Grundlage hatten. Skripte, die Test-Accounts mit Beispieldaten luden, führten anschließend die zeitgebundenen Funktionen in der Staging-Umgebung aus, ohne dabei echte Stripe-Kosten zu verursachen.
Falls Sie sich in diesem Spektrum noch in der Prototypenphase befinden, behandelt unser Artikel über ob „Vibe Coding“ schädlich für produktive Software ist die Lücke zwischen einer Demo und der Produktion.
KI-generierter Code erfordert überall dort eine Überprüfung durch erfahrene Entwickler, wo Fehler teuer oder unsichtbar sind: bei Authentifizierung, Zahlungen, Berechtigungen, Datenmigrationen, Abhängigkeitsänderungen und allem, was regulierte Daten betrifft. Code, der kompiliert und seine eigenen Tests besteht, ist nicht zwangsläufig sicher, da diese Tests oft vom selben Assistenten geschrieben wurden.
Der 2026 GenAI Code Security Report von Veracode ergab, dass generierter Code ohne sicherheitsspezifische Anleitung in etwa 44 % der Fälle Sicherheitstests nicht bestand, obwohl die syntaktische Korrektheit nahezu perfekt war. (Veracode vertreibt Sicherheitstests und hat Rohmodelle getestet; interpretieren Sie dies also als „unbeaufsichtigt“ und nicht als „zum Scheitern verurteilt“.) Die DORA-Studie 2025aus Googles langjährigem DevOps Research and Assessment-Programm bezeichnet KI als Verstärker: Die Einführung korreliert mittlerweile mit einem höheren Durchsatz bei der Bereitstellung, aber nach wie vor auch mit einer höheren Instabilität.
Auch die bekannteste Kennzahl zur Geschwindigkeit ist schlecht gealtert. Die Studie von METR aus dem Jahr 2025Eine von einer unabhängigen KI-Forschungsorganisation durchgeführte Studie ergab, dass 16 erfahrene Entwickler mit KI 19 % länger brauchten, obwohl sie glaubten, 20 % schneller zu sein. METR betrachtet diese Daten inzwischen als veraltet, da die Folgestudie von 2026 unzuverlässig war. Niemand kann Ihnen eine verlässliche Kennzahl nennen. Seien Sie vorsichtig bei jedem, der dies behauptet.
Was sollte ein Team also tun? Erklimmen Sie die sogenannte Review-Leiter: Je höher die Kosten eines Fehlers, desto erfahrener muss der Reviewer sein.
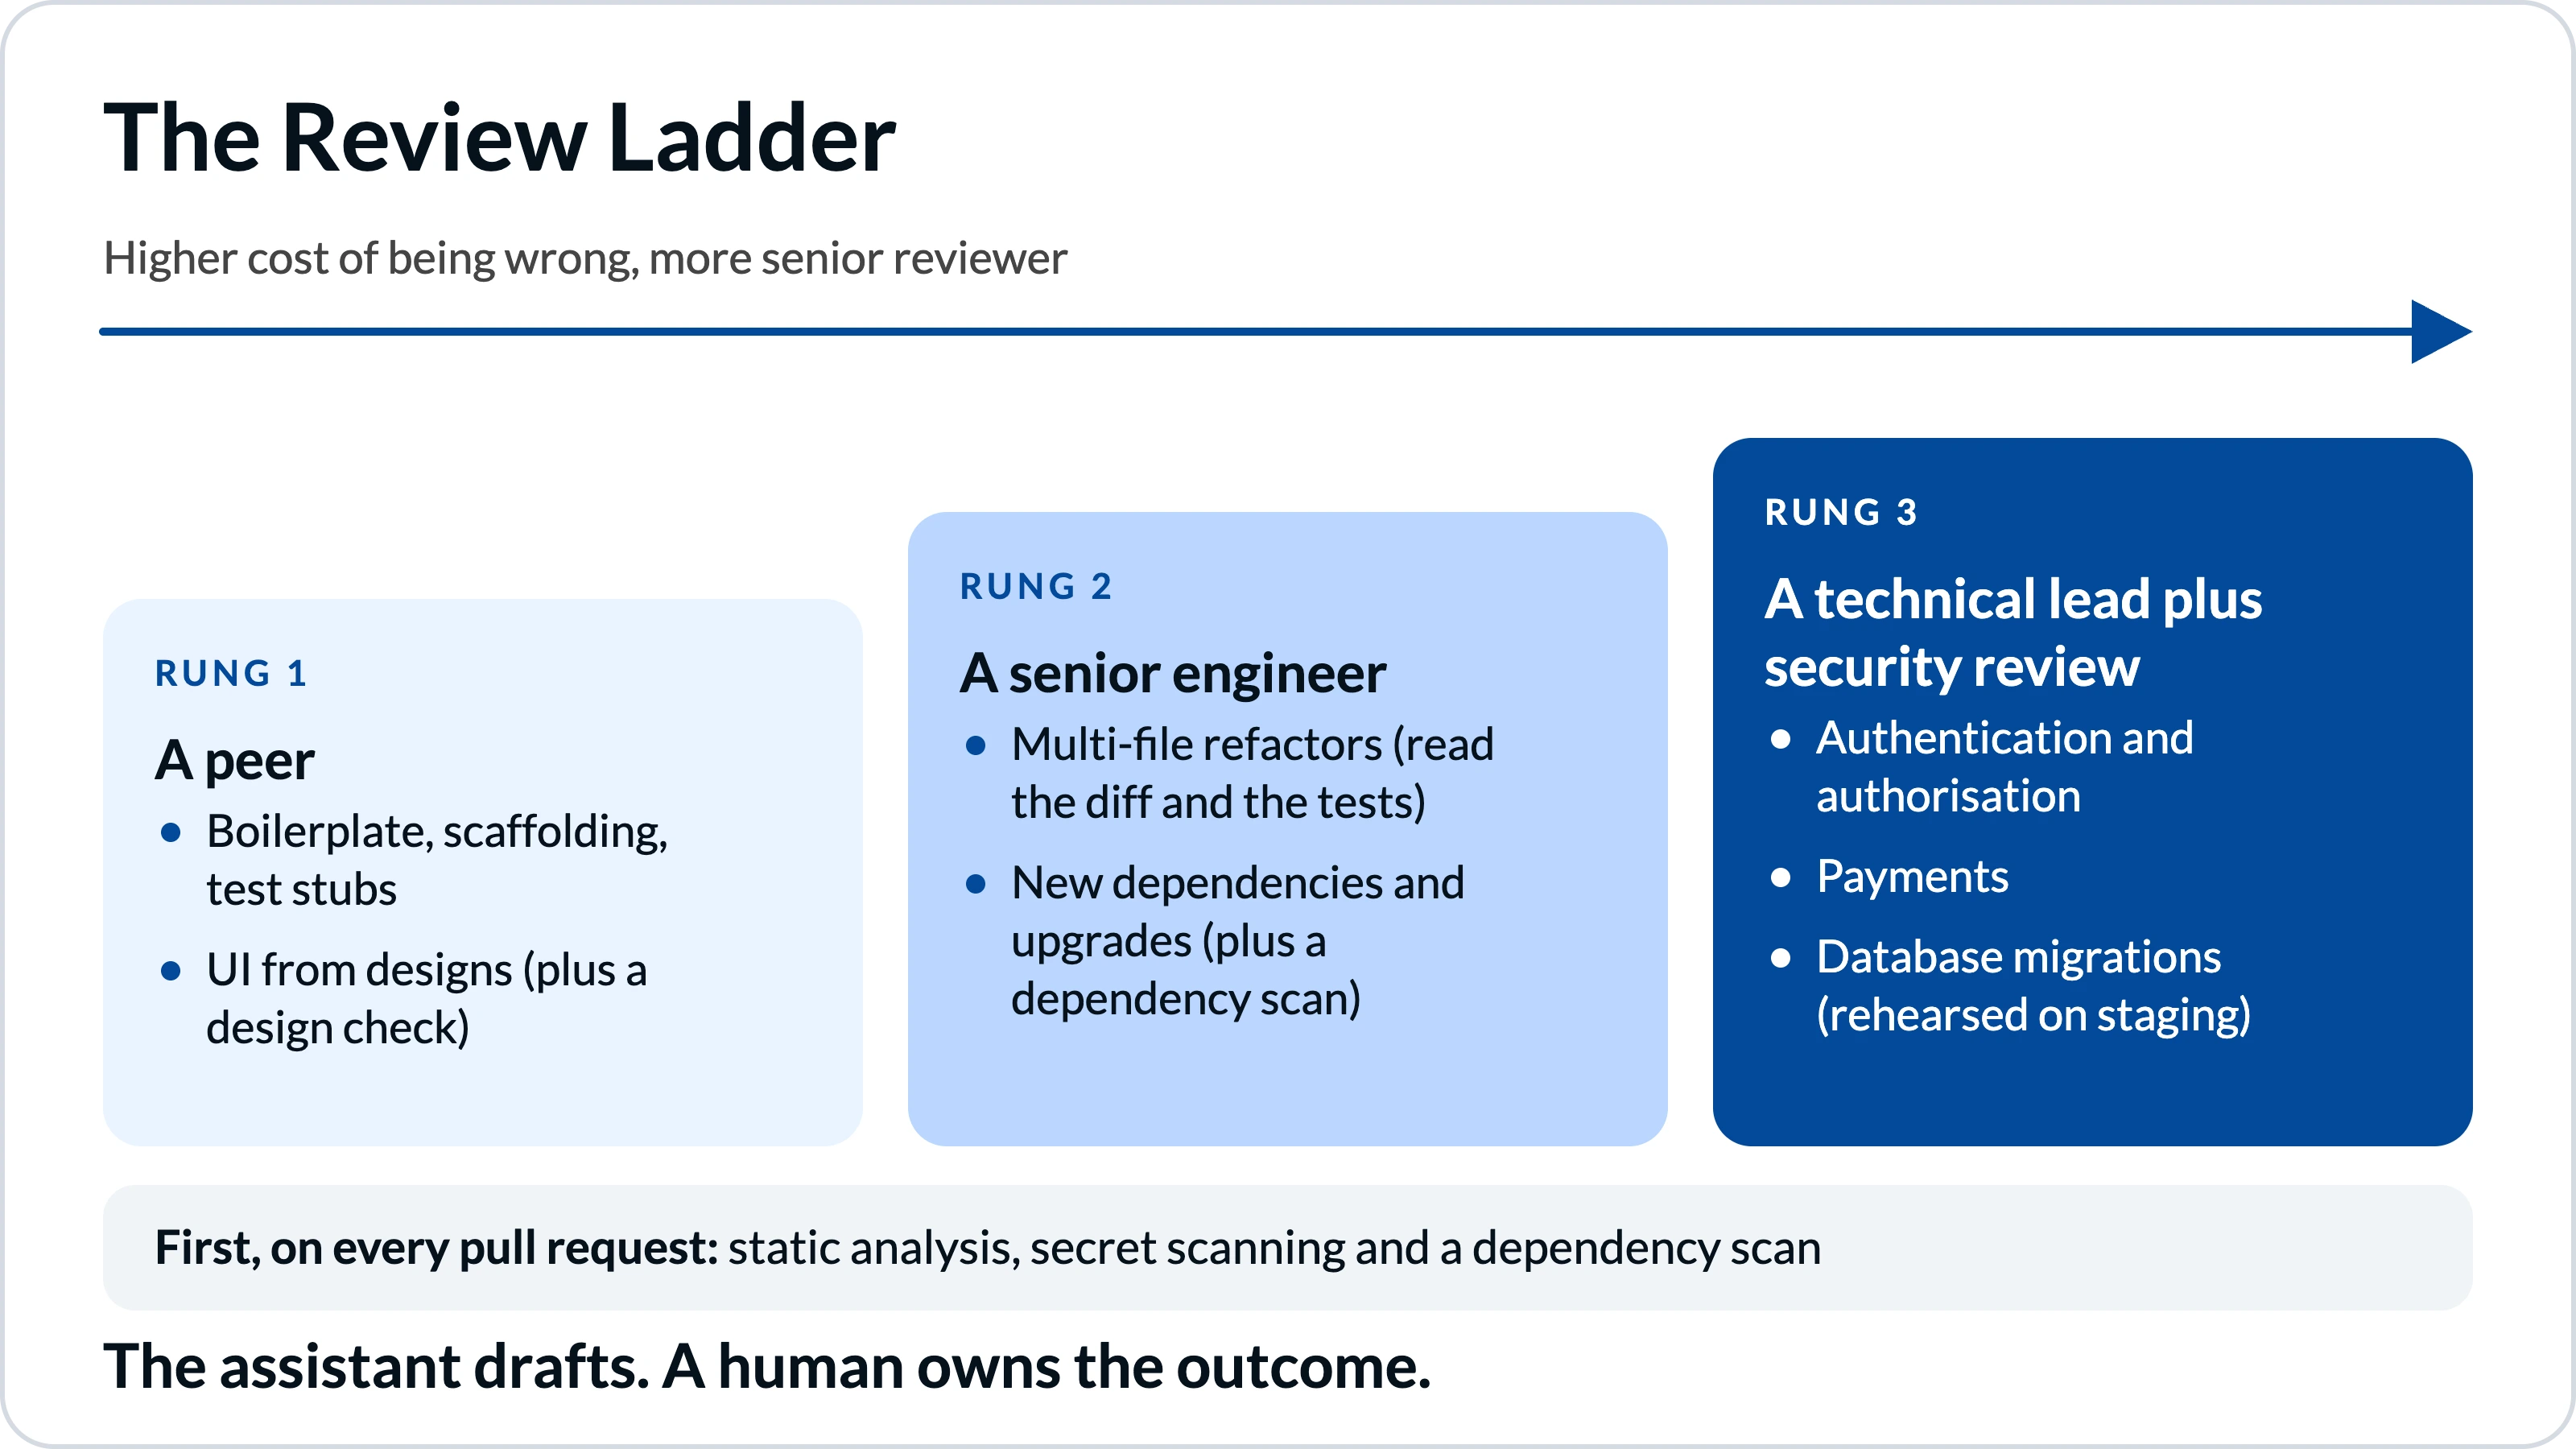
Passen Sie die Review-Leiter an Ihr eigenes Risikoprofil an. Das Prinzip bleibt gleich: Der Assistent entwirft den Code, ein Mensch verantwortet das Ergebnis.
Ein funktionierendes Gate besteht aus drei Teilen: automatisierte Prüfungen, bevor ein Mensch den Code sichtet, ein Reviewer, der das System versteht, und eine namentlich benannte Person, die für das Mergen verantwortlich ist. Geschwindigkeit entsteht durch den ersten Teil. Sicherheit entsteht durch die anderen beiden, und keiner davon kann an den Assistenten delegiert werden.
Bei unserer eigenen Bereitstellung gelangt kein Code ohne einen gemergten Pull Request in die Produktion, und dieser Merge erfordert die ausdrückliche Genehmigung eines Technical Leads. Er prüft jeden von einem Agenten generierten Pull Request auf Sicherheitskonformität, architektonische Ausrichtung und komplexe Geschäftslogik. Dasselbe Gate nutzen wir auch für unsere KI-gestützte Individualentwicklung . Wenn Sie Ihr eigenes Gate aufbauen, zahlen sich vier Gewohnheiten schnell aus:
KI-gestützte Code-Review-Tools wie Copilot Code Review oder Cursors Bugbot eignen sich am besten für einen ersten Durchlauf, um offensichtliche Fehler zu finden, bevor ein Mensch den Pull Request prüft. Sie ersetzen den Reviewer nicht und verursachen eigene Kosten.
Nutzen Sie KI-Code-Review-Tools, um menschliche Reviews zu beschleunigen, nicht um zu entscheiden, ob ein menschliches Review überhaupt stattfindet.
Wählen Sie die besten KI-Coding-Assistenten für Ihr Team nach Ihren Anforderungen aus, nicht nach Benchmarks. Verwalten Sie sie dann wie jede andere technische Änderung: Starten Sie einen Pilotversuch mit einer kleinen Gruppe, halten Sie die Richtlinien schriftlich fest und messen Sie die Ergebnisse anhand von Kennzahlen, die Sie bereits erfassen. Lizenzen ohne diesen Prozess führen zu einer Geschwindigkeit, die Sie nicht sicher nutzen können.
Vier Fragen grenzen die Auswahl schneller ein als jede Vergleichstabelle:
Führen Sie einen vierwöchigen Pilotversuch mit ein oder zwei freiwilligen Teams an echten Tickets durch, geben Sie jedem Tool dieselben drei Aufgaben und protokollieren Sie, was die Reviewer korrigieren mussten. Dieses Protokoll wird zu Ihrer Richtlinie und Ihrem Schulungsmaterial. Governance ist das Herzstück jeder Sicherheitsprüfung von KI-Coding-Tools in Unternehmen, und nur 24 % der Entwickler gaben an, dass ihr Unternehmen zugelassene Tools oder eine offizielle KI-Richtlinie veröffentlicht hat.
Behandeln Sie in regulierten Branchen einen KI-Coding-Assistenten wie jeden anderen Lieferanten, der mit Ihrem Code in Berührung kommt: Fordern Sie den SOC-2-Bericht, Aufbewahrungsfristen, Audit-Logs und Optionen zur Datenresidenz an und stufen Sie regulierte Daten auf der höchsten Sicherheitsstufe der Review-Skala ein. Planen Sie zudem Modelländerungen ein, da sich das Modell hinter Ihrem Assistenten jederzeit ändern kann.
Fragen Sie jeden Anbieter, wie viel Vorlaufzeit Sie erhalten, bevor ein Modell eingestellt oder ersetzt wird, und führen Sie Ihre drei Pilotaufgaben nach jeder größeren Änderung erneut durch. Wenn ein Output plötzlich mehr Überprüfung erfordert, möchten Sie das in einem Pilotprojekt feststellen und nicht erst in der Produktion.
Die tatsächlichen Kosten eines KI-Coding-Assistenten setzen sich aus Lizenzen, Nutzung, Anbieterabhängigkeit und der Zeit für Code-Reviews zusammen – wobei Letzteres in den meisten Budgets vergessen wird. Der Return on Investment hängt daher davon ab, ob die schnellere Erstellung von Code Ihre Review-Kapazitäten nicht überlastet, und nicht davon, wie schnell das Tool Code schreibt.
Lizenzen sind der sichtbare Kostenpunkt. Nutzungskredite, Zeitaufwand für Code-Reviews und die Stunden, die Senior-Entwickler mit dem Prüfen von KI-generierten Pull Requests verbringen, sind es nicht. Seit dem 1. Juni 2026 wird die Abrechnung von Copilot zudem nutzungsbasiert abgerechnet. Seien Sie skeptisch gegenüber Amortisationsrechnungen und messen Sie Ihre eigenen Werte: Verfolgen Sie die Durchlaufzeit, die Fehlerquote bei Änderungen und die Nacharbeitsrate vor und nach dem Pilotprojekt. Wenn der Durchsatz steigt und die Fehlerquote gleich bleibt, haben Sie einen Business Case. Steigen beide, haben Sie Geschwindigkeit mit Instabilität erkauft.
Bewerten Sie einen Vorfall in Ihrem eigenen Kontext – von den Arbeitsstunden der Ingenieure bis hin zu Auswirkungen auf Kunden und Audit-Risiken – und vergleichen Sie dies mit den jährlichen Lizenzkosten, bevor Sie entscheiden, wie viel Review-Kapazität Sie finanzieren. Vermeiden Sie bei der Anbieterabhängigkeit Verträge, die über Ihren Planungshorizont hinausgehen, und prüfen Sie, wie schnell Sie wechseln könnten.
Um dies einem Vorstand oder Beschaffungsausschuss vorzulegen, halten Sie das Konzept auf einer Seite: das Problem, ein vierwöchiges Pilotprojekt mit den oben genannten Liefermetriken als Erfolgskriterien, die Kosten inklusive Review-Kapazität, den Ausstiegsplan und ein Entscheidungsdatum. Das beantwortet auch die Frage nach der Time-to-Value: eine Go/No-Go-Entscheidung innerhalb eines Monats, nicht eines Jahres.
Es gibt nicht den einen „besten“, da die richtige Wahl davon abhängt, wo Ihr Team arbeitet. GitHub Copilot eignet sich für Teams, die auf GitHub setzen, da es direkt in Issues, Pull Requests und Actions integriert ist. Cursor ist ideal für Teams, die Agenten direkt im Editor nutzen möchten, und Claude Code eignet sich für Teams, die terminalbasiert arbeiten und skriptfähige Agenten bevorzugen. Testen Sie zwei Tools einen Monat lang an echten Aufgaben und entscheiden Sie dann basierend auf dem Review-Aufwand, den Datenkontrollen und den Kosten.
Keines ist pauschal besser. Copilot ist tief in GitHub-Issues, Pull Requests und Actions integriert, während Cursor ein auf Agenten ausgerichteter Editor ist. Teams, die auf GitHub standardisiert sind, beginnen oft mit Copilot. Prüfen Sie bei beiden die Eigentumsverhältnisse und Datenschutzbestimmungen.
Sie haben unterschiedliche Ansätze: Claude Code ist ein skriptfähiger Agent, während Copilot ein Assistent mit in GitHub integrierten Agenten ist. Entscheiden Sie nach Ihrem Workflow und den administrativen Kontrollmöglichkeiten und testen Sie nach Möglichkeit beide.
Es gibt keinen unabhängigen Test, der einen klaren Sieger für Ihre Codebasis kürt. Der Sicherheits-Benchmark von Veracode aus dem Jahr 2026 bewertete ein OpenAI-Modell mit 68 %, während sechs der 11 gelisteten Modelle zwischen 50 % und 53 % lagen, mit großen Unterschieden je nach Programmiersprache. Geben Sie jedem Tool dieselben drei echten Aufgaben und vergleichen Sie den Review-Aufwand.
Ja, sofern Ihre Review-Kapazität den zusätzlichen Code bewältigen kann. Ein kleines Team hat weniger Reviewer, um den Output zu prüfen. Beginnen Sie mit einem Tool, halten Sie Pull Requests klein und messen Sie während eines vierwöchigen Pilotprojekts die Fehlerquote bei Änderungen und den Nacharbeitsaufwand, bevor Sie das Projekt ausweiten.
Nein. Die Tests von Veracode aus dem Jahr 2026 ergaben, dass etwa 44 % des generierten Codes ohne Sicherheitsvorgaben Sicherheitstests nicht bestanden haben, und DORA bringt den Einsatz von KI mit einer höheren Instabilität bei der Bereitstellung in Verbindung. Nutzen Sie KI-Reviews als ersten Durchgang, aber halten Sie für jeden Merge einen namentlich benannten Menschen verantwortlich.
Setzen Sie die Datenschutzvorgaben des Anbieters unternehmensweit durch, lesen Sie die Ausnahmen und erstellen Sie eine Richtlinie. Cursor beispielsweise ermöglicht es Administratoren, den „Privacy Mode“ zu erzwingen, aber persönliche API-Schlüssel und einige Modelle fallen nicht unter die Bedingungen zur Null-Datenspeicherung.
Die Lizenzgebühren sind nur ein Teil der Kosten. GitHub hat Copilot am 1. Juni 2026 auf eine nutzungsbasierte Abrechnung umgestellt, sodass eine intensive Nutzung von Agenten das im Plan enthaltene Guthaben übersteigen kann. Kalkulieren Sie für Ihre intensivsten Nutzer und Code-Reviews und überprüfen Sie die Preise vierteljährlich.
Die besten KI-Coding-Assistenten sind diejenigen, bei denen Ihre Reviewer noch hinterherkommen. GitHub Copilot, Cursor, Claude Code und OpenAI Codex sind allesamt einen Test wert. Welches Tool das richtige ist, hängt davon ab, wo Ihr Team arbeitet, welche Daten Ihr Netzwerk verlassen dürfen und wie viel Autonomie Sie gewähren. Die Erfahrung zeigt: KI beschleunigt das Entwerfen, nicht das Urteilsvermögen. Generierter Code fällt weiterhin bei Sicherheitstests durch, die Stabilität bei der Bereitstellung sinkt und niemand verfügt über verlässliche Produktivitätskennzahlen. Erklimmen Sie also die „Review-Leiter“, testen Sie zwei Tools vier Wochen lang, messen Sie Ihre eigenen Ergebnisse und halten Sie die Richtlinien schriftlich fest.
Wenn Sie das tun, wird der Assistent zu einem echten Kraftverstärker. Wenn nicht, verlagern Sie den Engpass auf die Personen, deren Arbeit Sie sich am wenigsten leisten können zu verlangsamen.
Wenn Ihr Team mehr KI-generierten Code zusammenführt, als irgendjemand lesen kann, ist ein Code-Audit der schnellste Weg, um herauszufinden, was sich wirklich in der Produktion befindet. Das Code-Audit von Imaginary Cloud untersucht die Codestruktur, Qualität, Sicherheitslücken, Skalierbarkeitsgrenzen sowie technische Schulden und zeigt Ihnen einen klaren Weg auf, wie Sie die wichtigsten Probleme zuerst beheben. Es ist Teil unseres umfassenderen Technischen und UX-Audits -Services. Buchen Sie ein Gespräch und wir zeigen Ihnen, worauf Sie achten müssen.
Wir haben bereits ähnliche Projekte durchgeführt: ein Code-Audit für TeachTuttisowie Code-Standardisierung und architektonische Dokumentation für GoodBarber.
Alexandra Mendes ist Senior Growth Specialist bei Imaginary Cloud und verfügt über mehr als 3 Jahre Erfahrung in der Erstellung von Texten über Softwareentwicklung, KI und digitale Transformation. Nach Abschluss eines Frontend-Entwicklungskurses erwarb Alexandra einige praktische Programmierkenntnisse und arbeitet nun eng mit technischen Teams zusammen. Alexandra ist begeistert davon, wie neue Technologien Wirtschaft und Gesellschaft prägen. Sie liebt es, komplexe Themen in klare, hilfreiche Inhalte für Entscheidungsträger umzuwandeln.
People who read this post, also found these interesting: