Written by:

Last Published:
28. April 2021
•
Dieser Beitrag wurde ursprünglich veröffentlicht im Juli 2018 von Pedro Rolo und aktualisiert im Juni 2020 von Tiago Madeira .
Es gibt mehrere Funktionen, die Ruby on Rails attraktiv, aber wo es wirklich glänzt, ist, wenn es darum geht, Informationen aus relationalen Datenbanken abzurufen. Es ist ORM -Aktiver Datensatz - bietet jetzt eine sehr ausgereifte Oberfläche, die das richtige Gleichgewicht zwischen Prägnanz und Leistung bietet.
In diesem Artikel werde ich einige einfache Beispiele dafür geben, wie Informationen aus einer Datenbank extrahiert werden können. Dies soll kein umfassender Leitfaden sein, sondern eine Reihe von Tools, die ich in meiner täglichen Arbeit als nützlich empfunden habe. Außerdem basiert das, was ich im Folgenden vorstelle, auf dem neuesten Rails-Update (Rails 6).
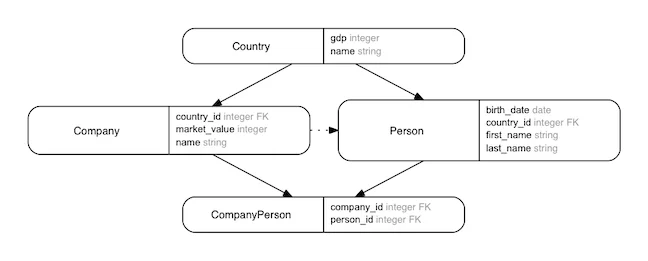
Ich beginne mit der Definition eines Domänenmodells, gegen das ich meine Abfragen ausführen werde:
Wir verwenden das folgende Domänenmodell in unseren Beispielen:
class Country < ApplicationRecord
  has_many :people
  has_many :companies
end

class Person < ApplicationRecord
  belongs_to :country
  has_many :company_people
  has_many :companies, through: :company_people
end

class Company < ApplicationRecord
  belongs_to :country
  has_many :company_people
  has_many :people, through: :company_people
end

class CompanyPerson < ApplicationRecord
  belongs_to :company
  belongs_to :person
end
Im Grunde Person und Company gehören zu einem Country, und Person und Company stehen in einer n:m-Beziehung zueinander, die in der Verknüpfungstabelle CompanyPersongespeichert ist.
Das #activerecord verbindet das Modell in unserer Ruby-Anwendung mit der entsprechenden Datenbanktabelle. Das ActiveRecord-Objekt bietet eine Reihe von Methoden, die uns beim Abfragen von Datenbankdatensätzen unterstützen, sodass kein rohes SQL erforderlich ist. Zu Vergleichszwecken zeigen wir die Übersetzung unserer ActiveRecord-Abfragen in SQL-Abfragen. Diese Übersetzung lässt sich ganz einfach mit #to_sqldurchführen.
Die einfachsten Abfragen beziehen sich nur auf eine einzelne Tabelle und zielen darauf ab, Datensätze mit bestimmten Werten in ihren Spalten zu finden.
Nehmen wir zum Beispiel an, wir möchten alle Personen finden, deren Vorname John ist:
Person.where(first_name: "John")
#=> #<ActiveRecord::Relation [#<Person id: 6941, first_name: "John", last_name: "Swift", birth_date: "1986-04-30", country_id: 68, created_at: "2018-05-28 16:32:50", updated_at: "2018-05-28 16:32:50">]>

# Wir können unsere Abfragen mit #to_sql ausgeben
Person.where(first_name: "John").to_sql
# SELECT "people".* FROM "people"
# WHERE "people"."first_name" = 'John'
Wir können auch Arrays mit gewünschten Werten anstelle von Einzelwerten verwenden. Dies generiert Abfragen, die das SQL-Schlüsselwort IN verwenden:
Person.where(first_name: ["Peter", "John"]).to_sql
# SELECT "people".* FROM "people"
# WHERE "people"."first_name" IN ('Peter', 'John')

Person.where(first_name: ["Peter", "John"])
#=> #<ActiveRecord::Relation [#<Person id: 5039, first_name: "Peter", last_name: "Corkery", birth_date: "1910-10-30", country_id: 63, created_at: "2018-05-28 16:32:19", updated_at: "2018-05-28 16:32:19">, #<Person id: 6941, first_name: "John", last_name: "Swift", birth_date: "1986-04-30", country_id: 68, created_at: "2018-05-28 16:32:50", updated_at: "2018-05-28 16:32:50">]>
Neben Arrays werden auch Bereiche (Ranges) als Wertprädikate akzeptiert:
Person.where(birth_date: (10.years.ago..5.days.ago))
# SELECT  "people".* FROM "people" WHERE "people"."birth_date"
# BETWEEN '2008-05-30' AND '2018-05-25'
Sie können auch endlose Bereiche verwenden:
# und für Objekte können wir Unendlichkeit in den Bereichen verwenden
Person.where(birth_date: (10.years.ago..Date::Infinity.new))
# SELECT  "people".* FROM "people" WHERE "people"."birth_date" >= '2008-05-28'
was ab Rails 6 einfach so geschrieben werden kann:
# und für Objekte können wir Unendlichkeit in den Bereichen verwenden
Person.where(birth_date: (10.years.ago..))
# SELECT "people".* FROM "people" WHERE "people"."birth_date" >= '2008-05-28'Es ist möglich, unsere Abfragen auf mehrere gleichzeitige Prädikate einzuschränken. Wir können entweder #where einen Hash mit mehreren Schlüsselwörtern übergeben oder mehrere Aufrufe von #whereverketten:
Person.where(first_name: ["Peter","John"],
             last_name: "Swift")
      .to_sql
# SELECT "people".* FROM "people"
# WHERE "people"."first_name" IN ('Peter', 'John')
#       AND "people"."last_name" = 'Swift'

Person.where(first_name: ["Peter","John"])
      .where(last_name: "Swift")
      .to_sql
# SELECT "people".* FROM "people"
# WHERE "people"."first_name" IN ('Peter', 'John')
#       AND "people"."last_name" = 'Swift'
Wenn wir unsere Prädikate stattdessen mit einem OR verknüpfen möchten, können wir #orverwenden.
are_swifts = Person.where(last_name: "Swift")

Person.where(first_name: ["Peter","John"])
      .or(are_swifts)
      .to_sql
# SELECT "people".* FROM "people"
# WHERE ("people"."first_name" IN ('Peter', 'John')
#       OR "people"."last_name" = 'Swift')
Wenn wir nur nach einer bestimmten Zeile suchen, können wir stattdessen #find_by verwenden, das die Suche abbricht, sobald der erste Treffer gefunden wurde, indem es LIMIT 1
Person.find_by(first_name: "Peter").to_sql
# SELECT  "people".* FROM "people"
# WHERE "people"."first_name" = 'Peter'
# LIMIT 1
Oder wir können unser eigenes Limit festlegen, indem wir #limit für unsere #where Abfragen:
Person.where(first_name: "Peter").limit(10).to_sql
# SELECT "people".* FROM "people"
# WHERE "people"."first_name" = 'Peter'
# LIMIT 10Es ist möglich, Datensätze abzurufen, die nicht einer bestimmten Bedingung entsprechen, indem man #not zusammen mit #whereverwendet:
Person.where.not(first_name: "Peter").to_sql
# SELECT "people".* FROM "people"
# WHERE "people"."first_name" != 'Peter'

Person.where(first_name: "Peter")
      .where.not(last_name: "Swift")
      .where(birth_date: 30.years.ago)
      .to_sql
# SELECT "people".* FROM "people"
# WHERE "people"."first_name" = 'Peter'
# AND "people"."last_name" != 'Swift'
# AND "people"."birth_date" = '1988-05-28'Es ist möglich, #order zu verwenden, um die Ergebnisse auf- oder absteigend zu sortieren:
Person.where.not(last_name: "Swift")
      .order(birth_date: :desc,
             created_at: :asc)
      .to_sql
# SELECT "people".* FROM "people"
# WHERE "people"."last_name" != 'Swift'
# ORDER BY "people"."birth_date" DESC,
# "people"."created_at" ASCEs gibt verschiedene Funktionen, mit denen sich ein Abfrageergebnis auf bestimmte Werte reduzieren lässt, wie zum Beispiel #count, #maximum, #minimum und #average:
Person.count # => 500
# SELECT COUNT(*) FROM "people"

Person.average(:birth_date) # => Mon, 01 Jan 1962
# SELECT AVG("people"."birth_date") FROM "people"

Person.maximum(:birth_date) # => Sat, 26 May 2018
# SELECT MAX("people"."birth_date") FROM "people"

Person.minimum(:birth_date) # => Mon, 29 Jun 1908
# SELECT MIN("people"."birth_date") FROM "people"
Zusätzlich ist es möglich, Elemente nach einer bestimmten Spalte zu gruppieren und diese Elemente mit den entsprechenden Aggregationsfunktionen zusammenzufassen, um so GROUP_BY -Abfragen durchzuführen:
Person.group(:last_name).count
# SELECT COUNT(*) AS count_all,
#        "people"."last_name" AS people_last_name
# FROM "people"
# GROUP BY "people"."last_name"
# => {"Abbott"=>13, "Abernathy"=>12, "Abshire"=>16, "Adams"=>18,
# ... Ergebnis gekürzt ...

Person.group(:last_name)
      .average(:birth_date)
# SELECT AVG("people"."birth_date") AS average_birth_date,
#        "people"."last_name" AS people_last_name
# FROM "people" GROUP BY "people"."last_name"
# => {"Abbott"=>#<BigDecimal:7fd61693d160,'0.1959307692 30769E4',27(36)>,
# "Abernathy"=>#<BigDecimal:7fd61693cda0,'0.19655E4',18(36)>,
# ... Ergebnis gekürzt ...Der häufigste Anwendungsfall bei mehreren Tabellen ist das Eager Loading von Entitäten, die mit unserem ausgewählten Modell verknüpft sind und auf die beispielsweise iterativ zugegriffen wird. Dieses Problem ist allgemein bekannt als das 1+N-Abfrageproblem und die folgende Interaktion macht es deutlich:
lazy_people = Person.where(last_name: "Smith")
lazy_people.map(&:country).map(&:name)
# SELECT "people".* FROM "people"
# WHERE "people"."last_name" = 'Smith'
# SELECT  "countries".* FROM "countries"
# WHERE "countries"."id" = 42 LIMIT 1
# SELECT  "countries".* FROM "countries"
# WHERE "countries"."id" = 60 LIMIT 1
# SELECT  "countries".* FROM "countries"
# WHERE "countries"."id" = 70 LIMIT 1
# SELECT  "countries".* FROM "countries"
# WHERE "countries"."id" = 68 LIMIT 1
# SELECT  "countries".* FROM "countries"
# WHERE "countries"."id" = 67 LIMIT 1
# SELECT  "countries".* FROM "countries"
# WHERE "countries"."id" = 64 LIMIT 1
# ...
# => ["Tschechische Republik", "Wallis und Futuna", "Belize", "Kuba", "Kuwait",
# "Liberia", ...]
Wie wir sehen, wird bei jedem Iterationsschritt einer Person eine neue Abfrage durchgeführt, um auf das zugehörige Land zuzugreifen.
#includes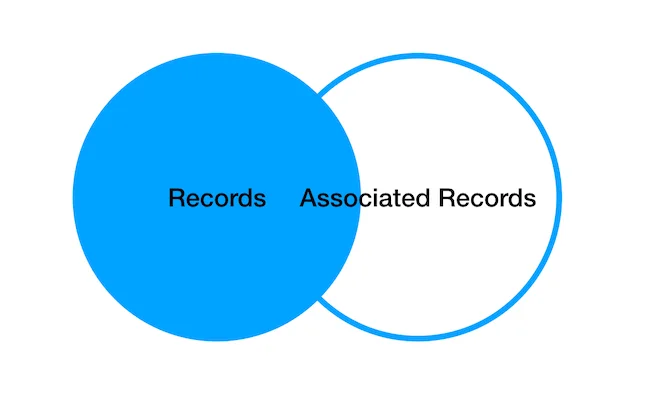
#includes ermöglichen es uns, alle Daten auf einmal vorab zu laden (Eager Loading) und so den oben beschriebenen Vorgang zu optimieren. Es verhält sich wie ein LEFT OUTER JOIN, wodurch alle Einträge des verknüpften Modells geladen werden, die unsere Haupteinträge betreffen.
eager_people = Person.where(last_name: "Smith")
                     .includes(:country)
# SELECT  "people".* FROM "people"
#  WHERE "people"."last_name" = 'Smith'
# SELECT "countries".* FROM "countries"
#  WHERE "countries"."id" IN (42, 60, 70, 80, 95, 102, 105, 200)

# und nun können wir über die Modelle und Beziehungen iterieren
# ohne zusätzliche Abfragen durchführen zu müssen, um
# z. B. den Namen jedes Landes abzurufen
eager_people.map(&:country).map(&:name)
# => ["Tschechische Republik", "Wallis und Futuna", "Belize", "Kuba", ...]
Moment mal, das ist kein LEFT OUTER JOIN – werden Sie vielleicht sagen! Nun, da es keine zusätzlichen Einschränkungen für die Länder gibt, die wir auswählen, greift Rails lieber auf eine WHERE id IN Abfrage zurück und nutzt dabei den Primärschlüssel-Index. Wenn wir jedoch Einschränkungen zu unserer Abfrage hinzufügen, führt Active Record stattdessen einen LEFT OUTER JOIN aus:
eager_people = Person.includes(:country)
                     .where(countries: {
                              gdp: -Float::INFINITY..1000000})
# SELECT  "people"."id" AS t0_r0,
#         "people"."first_name" AS t0_r1,
#         "people"."last_name" AS t0_r2,
#         "people"."birth_date" AS t0_r3,
#         "people"."country_id" AS t0_r4,
#         "people"."created_at" AS t0_r5,
#         "people"."updated_at" AS t0_r6,
#         "countries"."id" AS t1_r0,
#         "countries"."name" AS t1_r1,
#         "countries"."gdp" AS t1_r2,
#         "countries"."created_at" AS t1_r3,
#         "countries"."updated_at" AS t1_r4 FROM "people"
# LEFT OUTER JOIN "countries" ON "countries"."id" = "people"."country_id"
# WHERE "countries"."gdp" <= 1000000
# => ["Tschechische Republik", "Wallis und Futuna", "Belize", "Kuba",...]
Auffällig im obigen Beispiel ist die Verwendung eines Hashs in der WHERE-Bedingung, um Einschränkungen für unsere referenzierten Modelle festzulegen.
Wir können auch mehrere Beziehungen gleichzeitig vorab laden:
Person.includes(:country, :companies)
# SELECT  "people".* FROM "people"
# SELECT "countries".* FROM "countries"
#  WHERE "countries"."id" IN (5, 34, 50, 60)
# SELECT "company_people".* FROM "company_people"
#  WHERE "company_people"."person_id" IN (24, 10, 41, 35)
# SELECT "companies".* FROM "companies"
#  WHERE "companies"."id" IN (3, 32, 23, 65, 23)
Es ist auch möglich, dies verschachtelt zu tun, indem stattdessen ein Hash von Beziehungen übergeben wird:
Person.includes(country: :companies)
# SELECT  "people".* FROM "people" LIMIT ?  [["LIMIT", 11]]
# SELECT "countries".* FROM "countries"
# WHERE "countries"."id" IN (23,34,6,34,3,2,6,7)
# SELECT "companies".* FROM "companies"
# WHERE "companies"."country_id" IN (5,3,7,3,4,2,1)
# SELECT  "people".* FROM "people"
#joins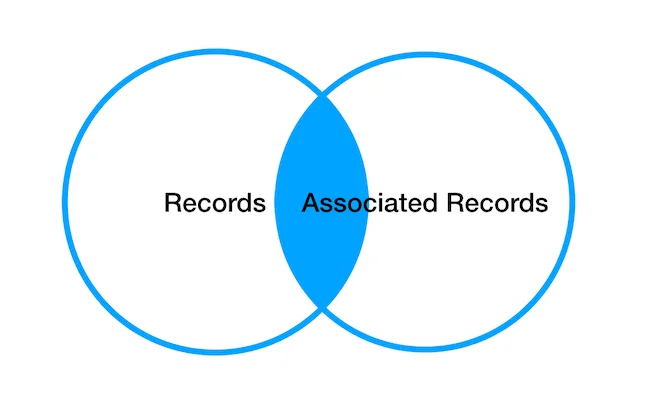
Manchmal interessieren uns nur die Datensätze, die mit dem zugehörigen Modul verknüpft sind. In diesem Fall verwenden wir #joins, was der Semantik eines INNER JOINentspricht.
Wir verdeutlichen die Notwendigkeit dieser Funktionalität am folgenden Beispiel, bei dem wir nur über Personen iterieren möchten, die tatsächlich einem Land zugeordnet sind:
# gegeben ein gewisser Ferdinand ohne Land
ferdinand_nobody = Person.find_by(country_id: nil)
# => #<Person id: 7042, first_name: "Fernando", last_name: "Pessoa",
# birth_date: "1888-06-13", country_id: nil,
# created_at: "2018-05-30 13:37:03", updated_at: "2018-05-30 13:37:03">

# beim Abfragen der Namen von Personen-Ländern
Person.includes(:country).map(&:country).map(&:name)
# NoMethodError: undefined method `name' for nil:NilClass
#        from (irb):27:in `map'
#        from (irb):27

# weil unser Ferdinand in dieser Liste enthalten ist
Person.includes(:country).include?(ferdinand_nobody) #=> true

# und sein Land nil ist
ferdinand_nobody.country #=> nil

# #joins zur Rettung
Person.joins(:country).include?(ferdinand_nobody) #=> false
# SELECT "people".* FROM "people"
# INNER JOIN "countries"
# ON "countries"."id" = "people"."country_id"

#=> alle Ländernamen der Personen
Person.joins(:country).map(&:country).map(&:name)
# SELECT "people".* FROM "people"
# INNER JOIN "countries"
# ON "countries"."id" = "people"."country_id"
Wenn wir uns nur für Datensätze interessieren, die mit einem verknüpften Modell mit bestimmten Attributwerten assoziiert sind, können wir #joins und anschließend #wo um Einschränkungen für unsere Modelle festzulegen.
Person.joins(:country).where(countries: { gdp: 110 })
#"SELECT "people".* FROM "people"
#INNER JOIN "countries"
#ON "countries"."id" = "people"."country_id"
#WHERE "countries"."gdp" = 110"
Die bisher geschriebenen Abfragen sind ziemlich lang. Wenn sie komplexer werden oder an verschiedenen Stellen im Code wiederverwendet werden sollen, ist es sinnvoll, ihnen Namen zu geben.
In älteren Rails-Versionen sollten Sie die ActiveRecord::Base#scope Klassenmethode verwenden, um solche wiederverwendbaren Abfragen zu erstellen. Sie können die gleiche Funktionalität jedoch auch einfach durch die Definition von Klassenmethoden erreichen:
def Person.adults
  _18_years_ago = (Time.now - 18.years)
  Person.where(
    birth_date: _18_years_ago..Date::Infinity.new)
end

def Person.from_big_economies
  Person
    .joins(:country)
    .where(countries: {
      gdp: 100_000.0..Float::INFINITY
    })
end
Nachdem Sie die Abfragen auf diese Weise definiert haben, können Sie diese Abstraktionen auf hoher Ebene miteinander verketten.
Person.from_big_economies.adults
# SELECT "people".* FROM "people"
# INNER JOIN "countries"
# ON "countries"."id" = "people"."country_id"
# WHERE "countries"."gdp" >= 100000
# AND "people"."birth_date" >= '2000-07-04'Arel ist eine domänenspezifische Sprache, mit der Sie Ihre Abfragen in relationaler Algebra ausdrücken können. In früheren Rails-Versionen war es recht üblich, auf Arel zurückzugreifen, um häufig benötigte Funktionen umzusetzen, obwohl Active Record in Rails 6 heutzutage bereits die meisten dieser Anwendungsfälle abdeckt.
Ich beginne damit, einige der bereits vorgestellten Rails-6-Abfragen mithilfe von Arel anstelle von einfachem Active Record zu präsentieren. Später konzentriere ich mich darauf, wie man Fälle schreibt, in denen man Arel immer noch benötigt.
Beim Erstellen von Arel-Abfragen beginnt man normalerweise damit, die Arel::Table Objekte der SQL-Tabellen abzurufen, mit denen wir interagieren möchten:
people = People.arel_table
# => #<Arel::Table:0x007ffc5def7c50 @name="people" ...>

countries = Country.arel_table
# => #<Arel::Table:0x007ffc5dcb2328 @name="countries" ...>
Wir können auf die Spalten unserer Tabellen wie auf einen Hash zugreifen. Von diesen Tabellen aus kann man Prädikate (Arel::Node) definieren, indem man Methoden auf deren Attributen aufruft, die über die Methode []zugänglich sind:
Die Prädikate #eq, #not_eq, #lt, #gt, #lteq, #gteq entsprechen den Operatoren =, !=, <, >, <=, >= und funktionieren wie folgt:
countries_predicate =  countries[:gdp].eq(10000)
# => #<Arel::Nodes::Equality:0x00007fd0141a29d0 ...>

people_lt_predicate = people[:birth_date].lt(Time.now - 10.years)
# => #<Arel::Nodes::LessThan:0x00007fd00baa0798 ...>

people_gt_predicate = people[:birth_date].gt(Time.now - 20.years)
# => #<Arel::Nodes::GreaterThan:0x007ffc5e1c47d0 ...>
Die #and & #or können verwendet werden, um tabellenübergreifende Prädikate zu erstellen, und funktionieren ähnlich wie hier:
or_predicate = countries[:gdp].gt(10000).or(people[:birth_date].gt(Time.now - 10.years))
# => #<Arel::Nodes::Grouping:0x00007fd0141d1ca8 ...>
and_predicate = countries[:gdp].gt(1000).and(countries[:gdp].lt(2000))
# => #<Arel::Nodes::And:0x00007fd0138b4648 ...>
Wir können diese Prädikate später an #whereübergeben, und solange die erforderlichen Tabellen verknüpft sind, wird das Prädikat erfolgreich in SQL konvertiert:
Person.joins(:country)
      .where(or_predicate)
# => SELECT "people".* FROM "people"
# INNER JOIN "countries"
# ON "countries"."id" = "people"."country_id"
# WHERE "countries"."gdp" > 10000
# OR "people"."birth_date" > '2008-07-04'Dies ist ein Anwendungsfall, bei dem man immer noch auf Arel zurückgreifen muss, um eine datenbankunabhängige Abfrage zu erhalten. Dazu sollte man die #matches Arel-Prädikat mit dem % SQL-Platzhalter:
people_last_name = Person.arel_table[:last_name]

Person.where(people_last_name.matches("A%"))
# SELECT  "people".* FROM "people"
# WHERE "people"."last_name" LIKE 'A%'
# => #<ActiveRecord::Relation [#<Person last_name: "Aufderhar" ... >, #<Person last_name: "Armstrong"...> ...]>
Dies gibt Personen zurück, deren Nachname mit dem Buchstaben „A“ beginnt.
Sowohl Arel als auch Active Record haben viel mehr Funktionen als die, die ich hier vorgestellt habe. Sie sind jedoch mehr als genug, um mit Anwendungen mit einfachen Anforderungen zu beginnen.
Am Ende kommt es darauf an, bei unseren alltäglichen Abfragen zwischen ActiveRecord-Abfragemethoden oder Arel zu wählen. Ich finde die ActiveRecord-Syntax einfacher zu lesen und zu verwenden, aber Arel kann immer noch nützlich sein, wenn es um komplexe Abfragen geht.
Rails-Entwickler mit mehr als 10 Jahren Erfahrung mit verschiedenen Technologien. Ich interessiere mich für funktionale Programmierung.
Informatikstudent und Teilzeitbeschäftigter von Imaginary Cloud. Begierig darauf, neue Technologien und Techniken zu erlernen. Tennis- und Klavierspieler.
People who read this post, also found these interesting: