Written by:
Last Published:
28. Oktober 2026
•
Data Mining ist eine Welt für sich, und genau deshalb wird es schnell unübersichtlich. Es gibt unglaublich viele Data-Mining-Tools auf dem Markt. Manche eignen sich besser für Data Mining im Big-Data-Bereich. Andere punkten mit ihren Funktionen zur Datenvisualisierung.
Kurz gesagt: Beim Data Mining geht es darum, Muster in Daten zu entdecken und Trends sowie Verhaltensweisen vorherzusagen. Einfach ausgedrückt: Es verwandelt riesige Datenmengen in relevante Informationen. (Riesige Datenmengen bringen wenig, wenn wir nicht wissen, was sie bedeuten.)
Dieser Prozess umfasst weitere Bereiche wie maschinelles Lernen, Datenbanksysteme und Statistik. Die Funktionen des Data Mining reichen von der Datenbereinigung über künstliche Intelligenz bis zu Datenanalyse, Regression, Clustering und mehr. Deshalb werden so viele Tools entwickelt und aktualisiert, die diese Funktionen abdecken und die Qualität großer Datensätze sicherstellen (denn schlechte Datenqualität führt zu schlechten und irrelevanten Erkenntnissen). Dieser Artikel zeigt Ihnen die besten Optionen für jede Funktion und jeden Kontext. Lesen Sie weiter, um unsere 20 besten Data-Mining-Tools kennenzulernen.
Data Mining ist der Prozess, mit Statistik, künstlicher Intelligenz und maschinellem Lernen Muster, Zusammenhänge und Trends in großen Datensätzen zu finden. Aus Rohdaten werden Informationen, die Sie lesen und umsetzen können. Data-Mining-Tools automatisieren diese Arbeit, von der Datenbereinigung bis zur Prognose, damit sich Ihr Team auf Entscheidungen konzentrieren kann.
Der Data-Mining-Prozess ermöglicht es, Muster und Beziehungen in Datensätzen zu entdecken sowie Trends und Verhaltensweisen vorherzusagen.
Technologische Fortschritte haben die automatisierte Datenanalyse schneller und einfacher gemacht. Je größer und komplexer die Datensätze, desto höher die Chance, relevante Erkenntnisse zu finden. Wer aussagekräftige Daten erkennt und versteht, kann wertvolle Informationen nutzen, um Entscheidungen zu treffen und die gesteckten Ziele zu erreichen.
Data Mining lässt sich für viele Zwecke einsetzen, etwa für Marktsegmentierung, Trendanalyse, Betrugserkennung, Datenbankmarketing, Kreditrisikomanagement, Bildung, Finanzanalyse und mehr. Je nach Ansatz der Organisation lässt sich der Prozess in mehrere Schritte unterteilen, umfasst aber in der Regel diese fünf Schritte:
Ein Data Warehouse ist ein System zum Sammeln und Verwalten von Daten. Es führt Daten aus verschiedenen Quellen in einem Repository zusammen und ist besonders vorteilhaft für operative Geschäftssysteme (z. B. CRM-Systeme). Es kommt vor dem Data Mining zum Einsatz, denn Letzteres sucht in den gespeicherten Daten nach Mustern und relevanten Informationen.
Vorteile eines Data Warehouse: bessere Datenqualität in den Quellsystemen; Schutz der Daten vor Updates der Quellsysteme; die Möglichkeit, mehrere Datenquellen zu integrieren; und Datenoptimierung.
Die richtige Data-Mining-Software hängt von der jeweiligen Aufgabe ab. SPSS, SAS und R eignen sich für statistische Analysen. KNIME ist Open Source, Apache Spark verarbeitet Big Data, Amazon EMR läuft in der Cloud, PyTorch passt zu neuronalen Netzen und Matplotlib erstellt Diagramme. Im Folgenden haben wir alle 20 Tools in sieben Kategorien unterteilt.
Data Mining ist ein äußerst nützlicher und vorteilhafter Prozess, der Unternehmen dabei helfen kann, Strategien auf der Grundlage relevanter Datenerkenntnisse zu entwickeln. Data Mining findet in vielen Branchen Anwendung (wie Versicherung, Bankwesen, Bildung, Medien, Technologie, Fertigung usw.) und bildet den Kern analytischer Bemühungen.
Der Data-Mining-Prozess kann aus verschiedenen Techniken bestehen. Zu den gebräuchlichsten gehören Regressionsanalyse (prädiktiv), Assoziationsanalyse (deskriptiv), Clustering (deskriptiv) und Klassifikation (prädiktiv). Es kann von Vorteil sein, bei der Entwicklung einer Analyse über zusätzliche Kenntnisse verschiedener Data-Mining-Tools zu verfügen. Bedenken Sie jedoch, dass diese Tools aufgrund der unterschiedlichen Algorithmen, die bei ihrer Entwicklung verwendet wurden, jeweils anders funktionieren.
Die wachsende Bedeutung von Data Mining in einer Vielzahl von Bereichen hat dazu geführt, dass ständig neue Tools und Software-Upgrades auf den Markt kommen. Folglich wird die Auswahl der richtigen Software zu einer schwierigen Aufgabe. Bevor Sie also voreilige Entscheidungen treffen, ist es entscheidend, die geschäftlichen oder forschungsbezogenen Anforderungen zu berücksichtigen.
Dieser Artikel hat die 20 besten Data-Mining-Toolszusammengetragen, die in sieben Kategorien unterteilt sind:
Beachten Sie, dass einige dieser Tools in mehrere Kategorien fallen können. Unsere Auswahl basiert auf der Kategorie, in der das jeweilige Tool am stärksten hervorsticht. Amazon EMR beispielsweise gehört zwar zu den Cloud-basierten Lösungen, ist aber gleichzeitig ein hervorragendes Tool für die Verarbeitung von Big Data. Bevor wir uns den eigentlichen Tools zuwenden, nutzen wir zudem die Gelegenheit, kurz den Unterschied zwischen den beiden beliebtesten Programmiersprachen für Data Science zu erläutern: R und Python. Obwohl beide Sprachen für die meisten Data-Science-Aufgaben geeignet sind, kann es (besonders am Anfang) schwierig sein, sich zwischen beiden zu entscheiden.
Python und R gehören zu den am häufigsten verwendeten Programmiersprachen für Data Science. Keine der beiden ist zwangsläufig besser als die andere, da beide Optionen ihre Stärken und Schwächen haben. Einerseits wurde R mit dem Fokus auf statistische Analysen entwickelt; andererseits bietet Python einen allgemeineren Ansatz für Data Science. Zudem ist R stärker auf die Datenanalyse ausgerichtet und bietet mehr Flexibilität bei der Nutzung verfügbarer Bibliotheken. Im Gegensatz dazu liegt das Hauptziel von Python in der Bereitstellung und Produktion, und es ermöglicht Ihnen, Modelle von Grund auf neu zu erstellen. Nicht zuletzt wird R häufig lokal ausgeführt, während Python in Anwendungen integriert ist. Trotz ihrer Unterschiede können beide Sprachen riesige Datenmengen verarbeiten und verfügen über eine breite Palette an Bibliotheken.
SPSS, SAS, Oracle Machine Learning for SQL (ehemals Oracle Data Mining) und R sind Data-Mining-Tools mit einem Schwerpunkt auf der statistischen Seite, im Gegensatz zu dem allgemeineren Ansatz für Data Mining, den beispielsweise Python verfolgt. Im Gegensatz zu den anderen Statistikprogrammen ist R jedoch keine kommerzielle integrierte Lösung, sondern Open-Source.
1. IBM SPSS
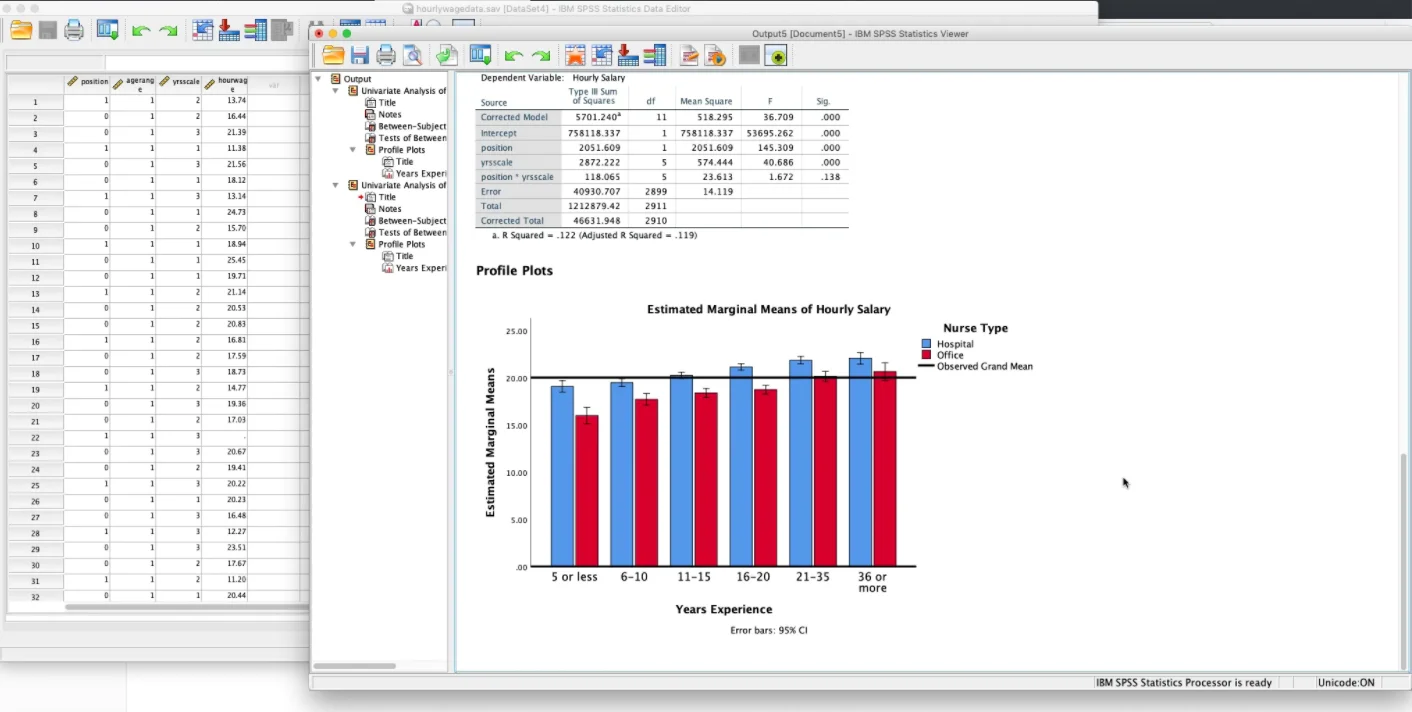
SPSS ist eine der am häufigsten genutzten Plattformen für Statistiksoftware. SPSS stand ursprünglich für Statistical Package for the Social Sciences, was auf den ursprünglichen Zielmarkt hinweist (Soziologie, Psychologie, Geografie, Wirtschaftswissenschaften usw.). Nachdem IBM die Software 2009 übernommen hatte, wurde SPSS ab 2015 als Statistical Product and Service Solutions bezeichnet. Die fortschrittlichen Funktionen der Software bieten eine breite Bibliothek an Algorithmen für maschinelles Lernen, statistische Analysen (deskriptiv, Regression, Clustering usw.), Textanalysen, Big-Data-Integration und vieles mehr. Darüber hinaus ermöglicht SPSS dem Benutzer, die SPSS-Syntax durch spezialisierte Erweiterungen mit Python und R zu ergänzen.
2. R
R ist eine Programmiersprache sowie eine Umgebung für statistische Berechnungen und Grafiken. Sie ist kompatibel mit UNIX-Plattformen, FreeBSD, Linux, macOS und Windows-Betriebssystemen. Diese freie Software kann eine Vielzahl statistischer Analysen durchführen, wie etwa Zeitreihenanalysen, Clustering sowie lineare und nicht-lineare Modellierungen. Zudem wird sie als Umgebung für statistische Berechnungen definiert, da sie als kohärentes System konzipiert ist und exzellente Pakete für Data Mining bereitstellt. Insgesamt R ist R ein hervorragendes und sehr umfassendes Werkzeug, das zudem grafische Funktionen für die Datenanalyse sowie eine umfangreiche Sammlung an Hilfsmitteln bietet. Es ist eine Open-Source-Alternative zu Statistiksoftware wie SAS und IBM SPSS.
3. SAS
SAS steht für Statistical Analysis System. Dieses Tool ist eine exzellente Option für Text Mining,OptimierungundData Mining. Es bietet zahlreiche Methoden und Techniken zur Erfüllung verschiedenster analytischer Anforderungen, die auf die Bedürfnisse und Ziele eines Unternehmens zugeschnitten sind. Dazu gehören deskriptive Modellierung (hilfreich zur Kategorisierung und Profilierung von Kunden), prädiktive Modellierung (praktisch zur Vorhersage unbekannter Ergebnisse) und präskriptive Modellierung (nützlich für Handlungsempfehlungen auf Basis vorhergesagter Ergebnisse). Zudem kann es unstrukturierte Daten wie E-Mails und Kommentarfelder parsen, filtern und transformieren. Darüber hinaus ermöglicht seine verteilte Speicherverarbeitungsarchitektur sorgt zudem für eine hohe Skalierbarkeit.
4. Oracle Data Mining
Oracle Data Mining (ODM) heißt jetzt Oracle Machine Learning for SQL und ist Teil von Oracle Machine Learning. Dieses Data-Mining-Tool bietet herausragende Algorithmen für Klassifizierung, Regression, Clustering, Assoziationsanalyse, Attributgewichtung und andere spezialisierte Analysen. Diese Eigenschaften ermöglichen es ODM , wertvolle Dateneinblicke und präzise Vorhersagen zu gewinnen. Darüber hinaus umfasst Oracle Machine Learning for SQL programmatische Schnittstellen für SQL, PL/SQL, R und Java.
5. KNIME
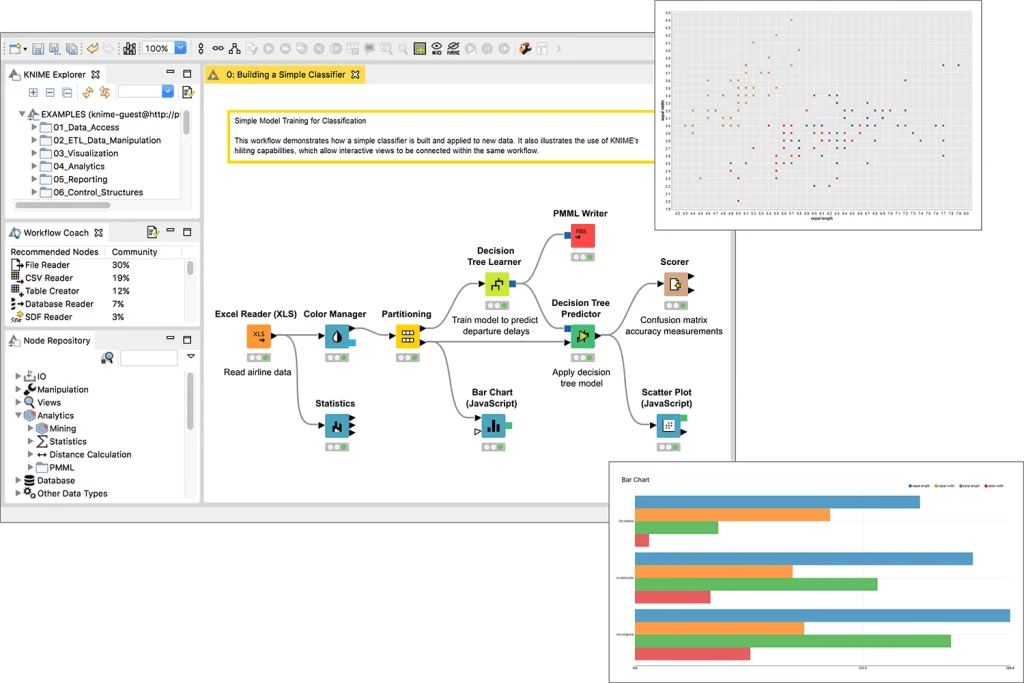
KNIME steht für Konstanz Information Miner. Die Software folgt einer Open-Source-Philosophie und wurde erstmals 2006 veröffentlicht. In den letzten Jahren wurde sie häufig als führende Plattform für Data Science und Machine Learningangesehen und findet in vielen Branchen Anwendung, etwa im Bankwesen, in den Biowissenschaften, bei Verlagen und in Beratungsunternehmen. Zudem bietet sie sowohl On-Premise- als auch Cloud- Konnektoren, was den Datentransfer zwischen verschiedenen Umgebungen erleichtert. Obwohl KNIME in Javaimplementiert ist, stellt die Software auch Knoten bereit, mit denen Benutzer sie in PythonundR.
6. Orange
Orange ist eine Python-basierte Open-Source-Data-Mining-Software. Sie ist ein hervorragendes Tool für Einsteiger im Bereich Data Mining, aber auch für Experten bestens geeignet. Neben den Data-Mining-Funktionen unterstützt Orange auch Machine-Learning-Algorithmen für Datenmodellierung, Regression, Clustering, Vorverarbeitung und mehr. Darüber hinaus bietet Orange eine visuelle Programmierumgebung sowie die Möglichkeit, Widgets und Verknüpfungen per Drag-and-Drop zu verschieben.
Big Data bezeichnet eine riesige Datenmenge, die strukturiert, unstrukturiert oder semi-strukturiert sein kann. Sie umfasst die fünf V-Merkmale: Volumen, Vielfalt, Geschwindigkeit, Wahrhaftigkeit und Wert. Big Data umfasst in der Regel mehrere Terabyte oder Petabyte an Daten. Aufgrund der Komplexität kann es schwierig (um nicht zu sagen unmöglich) sein, diese Daten auf einem einzelnen Computer zu verarbeiten. Daher können die richtige Software und Datenspeicherung äußerst hilfreich sein, um Muster zu erkennen und Trends vorherzusagen. Dies sind unsere Top-Empfehlungen für Data-Mining-Lösungen im Bereich Big Data:
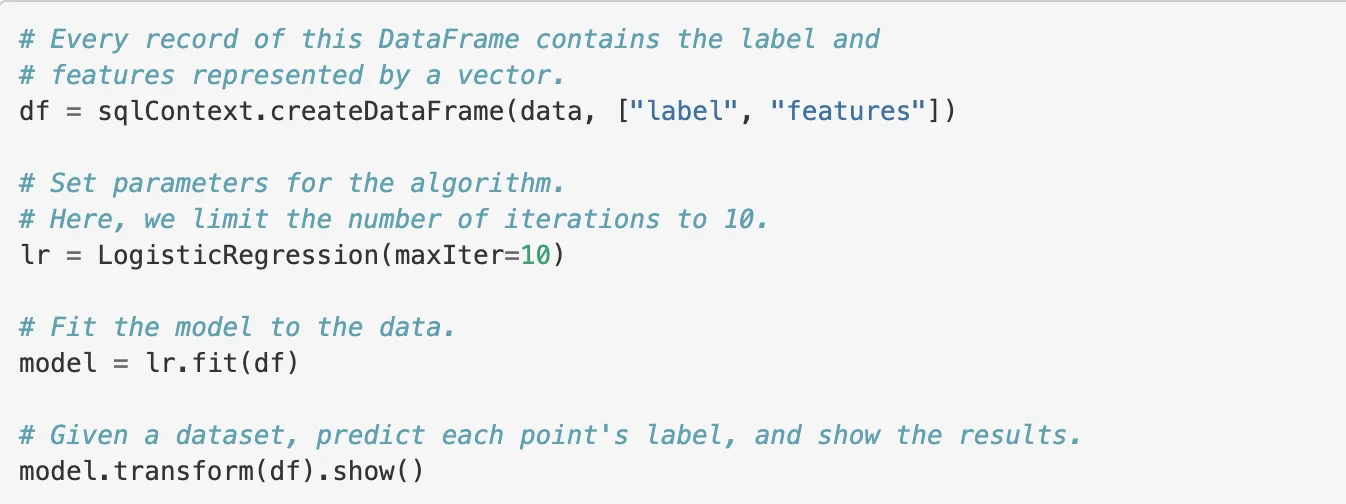
7. Apache Spark
Apache Spark zeichnet sich durch seine Benutzerfreundlichkeit bei der Verarbeitung von Big Data aus und ist eines der beliebtesten Tools. Es bietet zahlreiche Schnittstellen für Java, Python (PySpark), R (SparkR), SQL, Scala und stellt über achtzig High-Level-Operatorenbereit, mit denen sich Code schneller schreiben lässt. Zudem wird das Tool durch verschiedene Bibliotheken wie SQL und DataFrames, Spark Streaming, GraphX und MLlib ergänzt. Apache Spark überzeugt zudem durch seine beachtliche Performance und bietet eine schnelle DatenverarbeitungundDaten-Streaming -Plattform.
8. Hadoop MapReduce
Hadoop ist eine Sammlung von Open-Source-Tools zur Verarbeitung großer Datenmengen und zur Lösung komplexer Rechenprobleme. Obwohl Hadoop in Javageschrieben ist, kann jede Programmiersprache mit Hadoop Streaming verwendet werden. MapReduce ist eine Hadoop -Implementierung und ein Programmiermodell. Es ist eine weit verbreitete Lösung für die Durchführung komplexer Data-Mining-Prozesse bei Big Data. Vereinfacht ausgedrückt ermöglicht es Benutzern, Map- und Reduce-Funktionen zu definieren, wie sie üblicherweise in der funktionalen Programmierung verwendet werden. Dieses Tool kann umfangreiche Join-Operationen über riesige Datensätze hinweg ausführen. Darüber hinaus bietet Hadoop verschiedene Anwendungsmöglichkeiten wie die Analyse von Benutzeraktivitäten, die Verarbeitung unstrukturierter Daten, Log-Analysen, Text-Mining usw.
9. Qlik
Qlik ist eine Plattform, die Analysen und Data Mining mit einem skalierbaren und flexiblen Ansatz angeht. Sie verfügt über eine benutzerfreundliche Drag-and-Drop-Oberfläche und reagiert sofort auf Änderungen und Interaktionen. Darüber hinaus unterstützt Qlik zahlreiche Datenquellen sowie nahtlose Integrationen mit verschiedenen Anwendungsformaten, sei es durch Konnektoren und Erweiterungen, integrierte Apps oder API-Sätze. Es ist zudem ein hervorragendes Werkzeug, um relevante Analysen über einen zentralen Hub zu teilen.
10. Scikit-learn
Scikit-learn ist ein kostenloses Software-Tool für maschinelles Lernen in Python, das herausragende Funktionen für Data Mining und Datenanalyse bietet. Es umfasst eine Vielzahl von Features wie Klassifizierung, Regression, Clustering, Vorverarbeitung, Modellauswahl und Dimensionsreduktion.
11. Rattle (R)
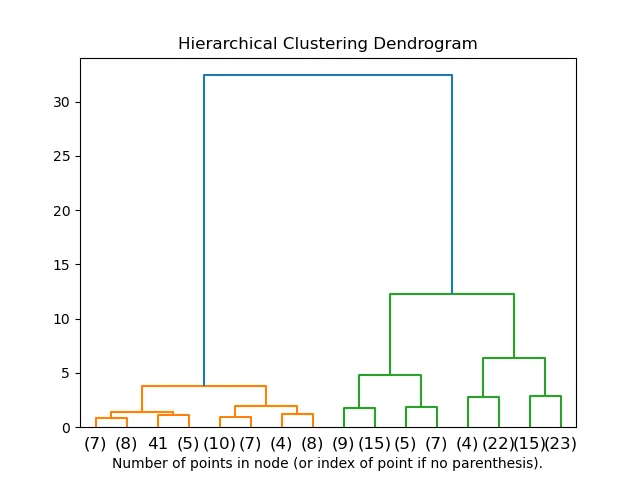
Rattle wurde in der R -Programmiersprache entwickelt und ist mit den Betriebssystemen macOS, Windows und Linux kompatibel. Es wird hauptsächlich von kommerziellen Unternehmen und Betriebensowie für akademische Zwecke genutzt (insbesondere in den Vereinigten Staaten und Australien). Die Rechenleistung von R ermöglicht es dieser Software, Funktionen wie Clustering, Datenvisualisierung, Modellierung und andere statistische Analysen bereitzustellen.
12. Pandas (Python)
Für Data Mining in Python Pandas ist ebenfalls ein weit verbreitetes Open-Source-Tool. Es handelt sich um eine Bibliothek, die sich besonders für die Datenanalyse und die Verwaltung von Datenstrukturen.
13. H3O
H3O ist eine Open-Source-Software für Data Mining, die hauptsächlich von Unternehmen zur Analyse von Daten in Cloud-Infrastrukturengenutzt wird. Dieses Tool ist in Java geschrieben, bietet jedoch RundPython -Schnittstellen für die Modellerstellung. Einer der größten Vorteile ist, dass H3O eine schnelle und einfache Bereitstellung in der Produktion ermöglicht.
Cloud-basierte Lösungen werden für das Data Mining immer wichtiger. Die Implementierung von Data-Mining-Techniken über die Cloud ermöglicht es Anwendern, wichtige Informationen aus virtuell integrierten Data Warehouses abzurufen, was die Kosten für Speicher und Infrastruktur senkt.
14. Amazon EMR
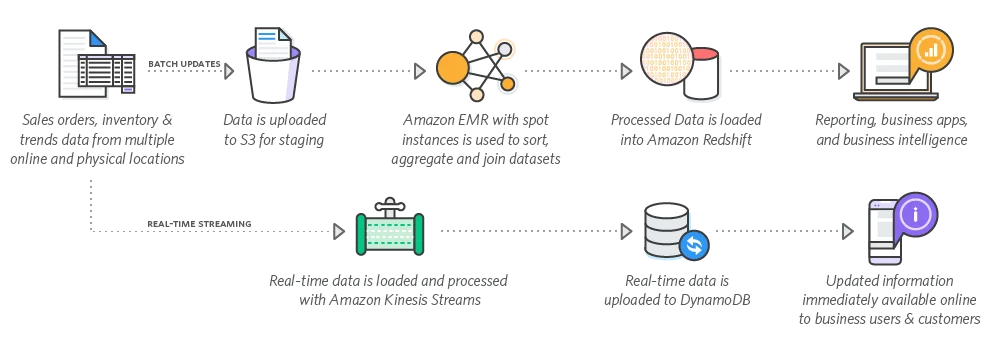
Amazon EMR ist eine Cloud-Lösung zur Verarbeitung großer Datenmengen. Anwender nutzen dieses Tool nicht nur für Data Mining , sondern auch für andere Aufgaben im Bereich Data Science, wie Web-Indizierung, Log-File-Analyse, Finanzanalysen, maschinelles Lernen usw. Diese Plattform nutzt eine Vielzahl von Open-Source-Lösungen (z. B. Apache Spark und Apache Flink) und erleichtert die Skalierbarkeit in Big-Data-Umgebungen durch die Automatisierung von Aufgaben (zum Beispiel die Optimierung von Clustern).
15. Azure ML
Azure ML ist eine cloudbasierte Umgebung, die für das Erstellen,Trainierenundund Bereitstellen von Machine-Learning-Modellen entwickelt wurde. Für das Data Mining kann Azure ML prädiktive Analysen durchführen und ermöglicht es Benutzern, Datenmengen von der Cloud-Plattform aus zu berechnen und zu bearbeiten.
16. Gemini Enterprise Agent Platform
Ähnlich wie Amazon EMR und Azure ML ist die Gemini Enterprise Agent Platform (ehemals Vertex AI und ursprünglich Google AI Platform) ebenfalls cloudbasiert. Diese Plattform bietet einen der umfangreichsten Machine-Learning-Stacks. Die Plattform umfasst verschiedene Datenbanken, Machine-Learning-Bibliotheken und weitere Tools, die Benutzer in der Cloud für Data Mining und andere Data-Science-Funktionen einsetzen können.
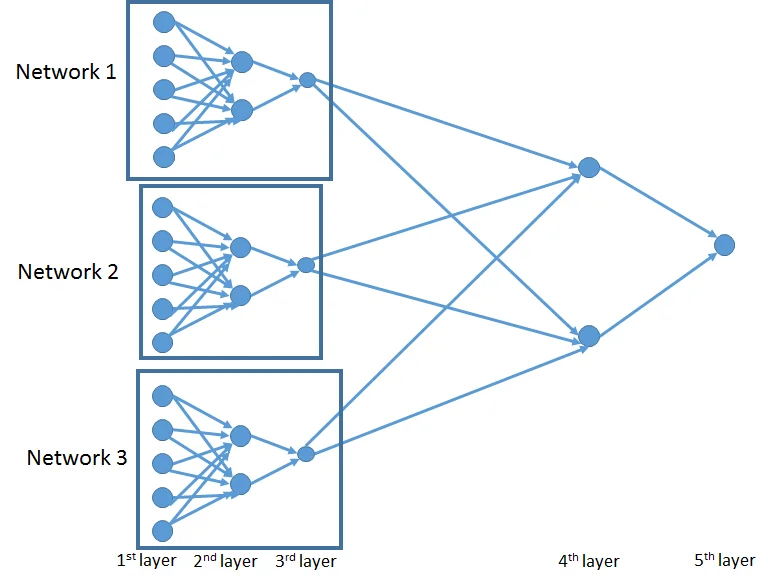
Neuronale Netze basieren darauf, Daten so zu assimilieren, wie es das menschliche Gehirn bei der Informationsverarbeitung tutUnser Gehirn verfügt mit anderen Worten über Millionen von Zellen (Neuronen), die externe Informationen verarbeiten und anschließend ein Ergebnis liefern. Neuronale Netze folgen demselben Prinzip und können für das Data Mining genutzt werden, indem sie Rohdaten in relevante Informationen umwandeln.
17. PyTorch
PyTorch ist ein Python-Paket und ein Deep-Learning-Framework, das auf der Torch-Bibliothek basiert. Es wurde ursprünglich vom Fundamental AI Research (FAIR) Lab von Meta, ehemals Facebook AI Research, entwickelt und ist aufgrund seiner Funktionen für tiefe neuronale Netze ein sehr bekanntes Werkzeug in der Data Science. PyTorch wird heute von der PyTorch Foundation verwaltet, die seit September 2022 unter dem Dach der Linux Foundation angesiedelt ist. Es ermöglicht Anwendern die Durchführung von Data-Mining-Schritten zur Programmierung eines vollständigen neuronalen Netzes: Laden von Daten, Vorverarbeitung, Modelldefinition, Training und Evaluierung. Zudem ermöglicht PyTorch dank einer starken GPU-Beschleunigungeine schnelle Array-Berechnung. Im September 2020 wurde die Bibliothek auch für Rverfügbar gemacht. Das „torch for R“-Ökosystem umfasst torch, torchvision, torchaudio und weitere Erweiterungen.
18. TensorFlow
Ähnlich wie PyTorch ist TensorFlow ebenfalls eine Open-Source-Python-Bibliothek für maschinelles Lernen, die ursprünglich vom Google Brain-Team entwickelt wurde (Google Brain ist seit der Fusion im April 2023 Teil von Google DeepMind). Sie kann zum Aufbau von Deep-Learning-Modellen verwendet werden und legt einen starken Fokus auf tiefe neuronale Netze. Neben einem flexiblen Ökosystem an Toolsbietet TensorFlow auch weitere Bibliotheken und verfügt über eine weithin beliebte Community , in der Entwickler Fragen stellen und sich austauschen können. Obwohl es sich um eine Python-Bibliothek handelt, führte TensorFlow 2017 eine R-Schnittstelle von RStudio zur TensorFlow-API ein.
Datenvisualisierung ist die grafische Darstellung der Informationen, die aus dem Data-Mining-Prozess gewonnen wurden. Diese Tools ermöglichen es Anwendern, ein visuelles Verständnis der Datenerkenntnisse (Trends, Muster und Ausreißer) durch Grafiken, Diagramme, Karten und andere visuelle Elemente zu erlangen.
19. Matplotlib
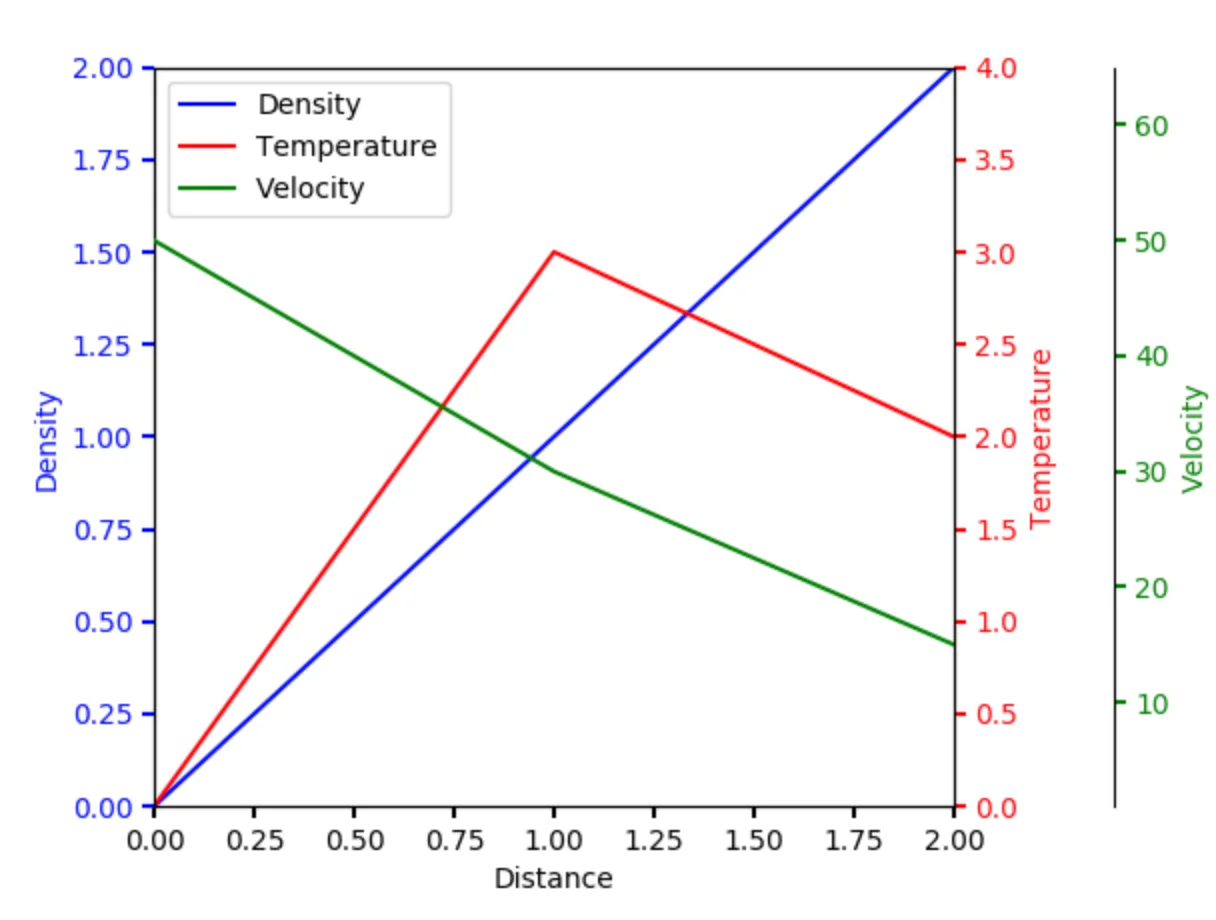
Matplotlib ist ein hervorragendes Werkzeug zur Datenvisualisierung in Python. Diese Bibliothek ermöglicht die Verwendung von interaktiven Diagrammen und die Erstellung hochwertiger Grafiken (zum Beispiel Histogramme, Streudiagramme, 3D-Plots und Bilddarstellungen), die anschließend angepasst werden können (Stile, Achseneigenschaften, Schriftarten usw.).
20. ggplot2
ggplot2 ist ein Werkzeug zur Datenvisualisierung und eines der beliebtesten R-Pakete. Dieses Tool ermöglicht es Benutzern, Komponenten innerhalb eines Diagramms mit einem hohen Abstraktionsgrad zu bearbeiten. Darüber hinaus erlaubt es die Erstellung nahezu jeder Art von Grafik sowie die Verbesserung der Qualität und Ästhetik der Darstellungen.
Beginnen Sie mit Ihren Zielen. Wählen Sie zuerst das Tool, das zu den Anforderungen Ihres Unternehmens oder Ihrer Forschung passt, und kümmern Sie sich dann um die Funktionen. Die meisten Data-Mining-Tools setzen auf R oder Python, während integrierte Statistikplattformen wie SAS und SPSS bei Organisationen beliebt bleiben. Mehrere Tools zu lernen ist üblich und zahlt sich aus.
Noch immer 20 Tools und kein klarer Favorit? Sprechen Sie uns an, wir helfen Ihnen beim Eingrenzen.
Marketing-Praktikant mit besonderem Interesse an Technologie und Forschung. In meiner Freizeit spiele ich Volleyball und verwöhne meinen Hund, wo ich nur kann.
Data Scientist mit einer großen Leidenschaft für Ingenieurwesen, Physik und Mathematik. In meiner Freizeit höre und mache ich gerne Musik, reise viel und bin auf dem Mountainbike unterwegs.
Datenwissenschaftler, der es liebt, herausfordernde Probleme anzugehen. In meiner Freizeit backe ich, mache lange Spaziergänge und lese über Genomik und Ernährung.
People who read this post, also found these interesting: